SolidigmがAI Infrastructure Field DayでAIストレージを再定義
SolidigmとMinIOがAI Infrastructure Field Day 2026にて、AIストレージの密度、G3.5ストレージ層、そしてAIメモリとしてのストレージについて議論しました
妥協のない密度
セクション 1:クラスタ規模のパフォーマンスを実現させるストレージ密度
AI Infrastructure Field Day 5は、現実を直視するところから幕を開けました。アリン・マルヴェンターノは、2年前のストレージ構成図を取り上げました。それらのスライドにすら、KVキャッシングは登場していませんでした。実際、当時はこの層について議論に出てくることさえありませんでした。しかし今では、それはAI推論のパフォーマンスにおける中心的存在になっています。この分野は変化が速いものです。Solidigmがこの新しい層に何をもたらすのか、ご紹介できることを大変嬉しく思います。さて、背景説明はこれくらいにして、数字を具体的に見ていきましょう。
Solidigmは、AIストレージのピラミッドの全スタックを網羅しています。HBMとDRAMは供給が逼迫し、価格上昇に直面しています。G3.5コンテキスト層とG4共有ストレージ層は、容量が重視される層です。Solidigm D5-P5336が、その大容量層を支えます。D7-PS1010は、ローカルおよびコンテキストストレージ向けにフラッグシップ級のパフォーマンスを発揮します。
本セクションで取り上げている項目
- 学習、ファインチューニング、推論の全体にわたるAIストレージフロー
- G1~G4メモリ階層とG3.5コンテキスト層
- KVキャッシュの計算:ユーザーリクエスト1件あたり13.1GB(42,000トークン時。Llama 3 70B)
- コンテキストを再利用することで再コンピューティングのコストを解消できる理由
ストレージはもはや、単なる永続性実現手段ではありません。ベクトルインデックスとKVキャッシュが SSDにオフロードされると、ストレージはメモリのようになります。
セクション 2:24PBクラスタ — TCPベースライン結果
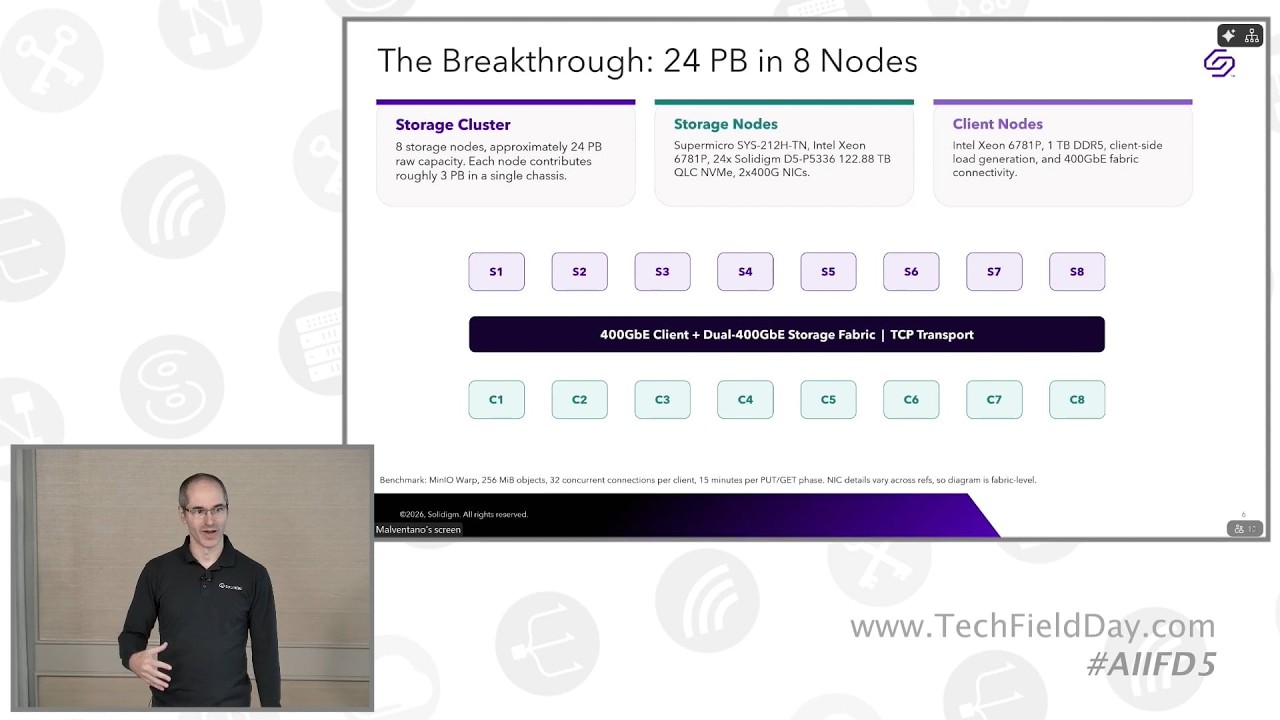
まずは、MinIOを使用したクラスタ規模の検証です。セットアップは単純明快でした。8台のクライアントシステムが8台のストレージサーバーに接続する、8×8構成です。各ストレージノードには、Solidigm D5-P5336 122TBドライブが 24台搭載されています。総物理容量は24ペタバイトです(計算している方のために補足すると、これはシャーシあたり約3PBとなります)。
MinIO WarpでGPUストレージのワークロードをエミュレートしました。クライアント・ストレージ間のトラフィックは、クライアントあたり1枚の400ギガビットイーサネットNICを経由して行われました。ストレージノードには、クライアント向けとノード間トラフィックの両方に対応するため、400GbEが2つ搭載されていました。
本セクションで取り上げている項目
- 約24PBの物理容量を提供する8ノードクラスタ
- ストレージノードあたり24台のSolidigm D5-P5336 122TB QLC SSD(シャーシあたり約3PB)
- 負荷生成用のSolidigm D7-PS1010 TLCドライブ(クライアントシステム)
- 256 MiBオブジェクトでのMinIO Warpベンチマーク
- 最大GET:8 クライアントで268 GiB/s
- 最大PUT:7~8クライアントで120 GiB/s
- 全16回のテスト実行でエラーなし
ベースラインのパフォーマンスは、8ノードまでほぼ線形にスケールしました。ファーストバイトレイテンシは、中央値で3msから5msの範囲に収まりました。TCP(Transmission Control Protocol)経由で毎秒250ギガバイトを上回っているのは、TCP固有のオーバーヘッドを考慮すると極めて高い数字です。素晴らしい結果です。これらの数値は注目に値します。通常、TCPではこうした数値に達するはるか手前で処理能力が低下するものと予想されます。その規模に驚かないでください。これは、問題に対して十分な並列処理を適用した結果なのです。
このクラスタ設計は、MinIO ExaPODリファレンスアーキテクチャの構成要素です。同一のノード構成でペタバイトからエクサバイトまで拡張可能です。
セクション 3:パフォーマンス3倍への道のり — スタックのチューニング
当初の数値は良好でした。チューニング後の数値はさらに向上しました。一般的な構成と比較しておよそ3倍の改善が見られました。
フェーズ 1では、LinuxとMinIOのデフォルト設定でTCPベースラインを確立しました。フェーズ 2では、OSとファブリックのチューニングを通じて、スケジューリングのジッター、パケットのオーバーヘッド、および輻輳によるボトルネックを解消しました。フェーズ 3 では、最大スループットを実現できるよう、CPU、NIC、TCP、スイッチファブリック、およびMinIOのレイアウトを相互調整的にチューニングしました。問題点といえば、各フェーズでチューニングの複雑さが増していった点です。
本セクションで取り上げている項目
- 3段階のチューニング手法
- SMT無効化、NIC割り込みの固定
- MinIOイレイジャーセットのチューニング:イレイジャーセット 24個、各セットに8ドライブ、EC:4
- ケーブル長に基づくスイッチおよびNICのバッファ調整
- 各フェーズにわたって追跡されるGiB/sあたりのCPUコスト
このチューニング作業が重要となるのは、それが次の段階のための比較基準を設定するからです。まずはクリーンなTCPベースラインがなければ、RDMA(Remote Direct Memory Access)による効果を測定することはできません。
セクション 4:TCPの先へ — デュアルパス接続とRDMA
Solidigmは、さらなるパフォーマンスの向上を追求しています。これに関して、注目すべき2 のアプローチがあります。
1つ目は、デュアルパス接続よるイニシエータ帯域幅の倍増です。この点は、NVIDIA B200やB300などの計算リソースノードとの将来的な統合において、特に重要とになります。
2つ目は、データ転送時のCPUオーバーヘッドを回避するRDMAです。RDMAは、ネットワークアダプタ間での直接的なメモリ間通信を可能にします。ゼロコピー、カーネルバイパス、マイクロ秒単位のレイテンシ。この規模になると、TCPオーバーヘッドは大幅に低下します。この分野については、近日中にさらなる情報をお届けする予定です。
本セクションで取り上げている項目
- NVMeよりも先にTCPオーバーヘッドがボトルネックとなる
- RDMAのメリット:ゼロコピー、カーネルバイパス、マイクロ秒単位のレイテンシ
- 最大スループットを実現するためのデュアルパス接続 + RDMAの組み合わせ
- レイヤーごとにチューニングの複雑さが増す
今回は、試しにDRAMを使ってGPUメモリをシミュレートしてみました。RDMAは依然として、CPUのボトルネックを軽減し、より高いスループットを実現する効果が期待できます。デュアルパス接続とRDMAを併用すると、チューニングの複雑さが増しますが、パフォーマンスの向上という見返りがあるため、取り組んでいくだけの価値があります。
MinIO MemKV:G3.5層の稼働
プレゼンテーションは、TCPベースラインについての後、MinIO MemKVの説明に移りました。これはG3.5のコンセプトの実践です。
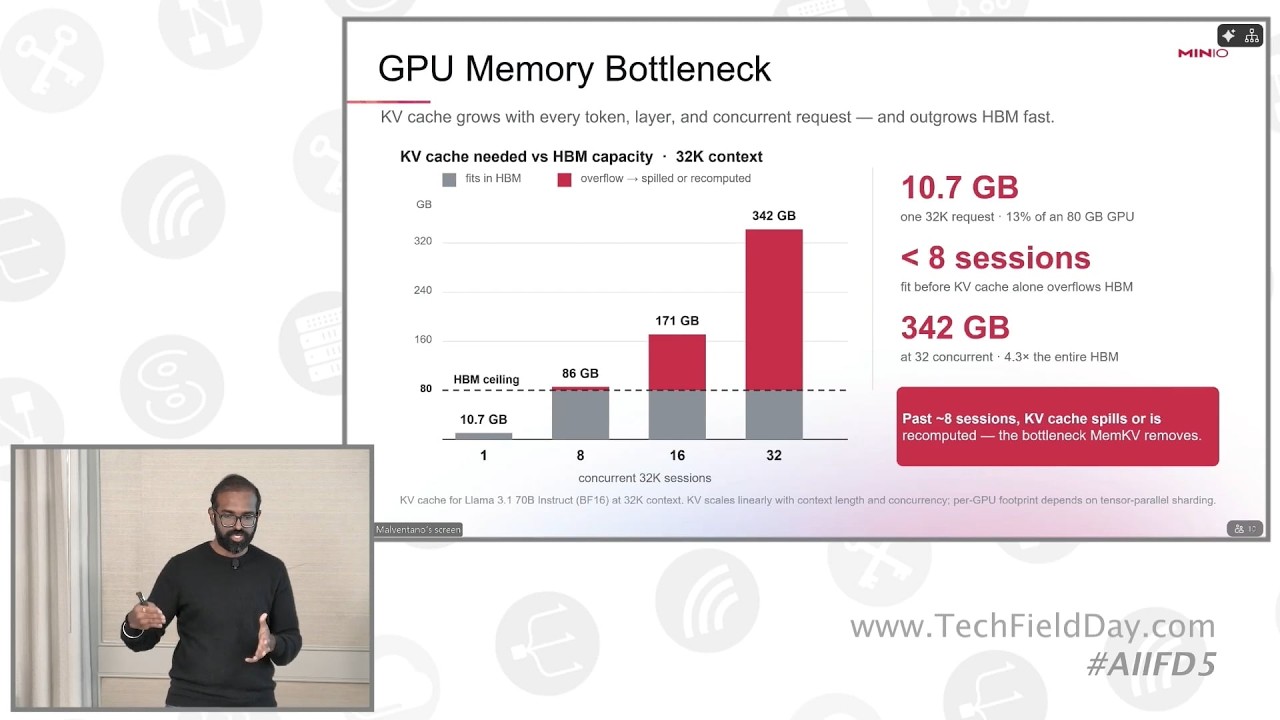
KVキャッシュは、GPUのHBM容量を頻繁に超えてしまいます。エージェント型ワークロードでは、コンテキストメモリが絶えず拡大します。HBM が満杯になると、GPUはKVキャッシュをエヴィクトし、再計算します。これにより、プリフィル中のサイクルが無駄になり、TTFT(Time to First Token)が増加します。
本セクションで取り上げている項目
- 分散共有コンテキストメモリとしてのMinIO MemKV
- NVMeへのダイレクトアクセス、マイクロ秒単位のレイテンシ
- ファイルシステムやカーネルのオーバーヘッドなし
- GPUノードあたりの同時リクエスト数が43倍に増加
- 97 GB/sの集約スループット
- スーパーポッドにおいて、1秒あたり16,000件の同時リクエストまでスケーリング可能
MemKVはNVMeへのダイレクトアクセスを活用することで、従来のファイルシステムとカーネルのオーバーヘッドをバイパスします。これはメモリの拡張として設計されており、一時的なKVキャッシュデータには不要である永続性機能は備えていません。
講演者らは、これについては、CXLのような複雑なハードウェアではなく、最適化されたソフトウェアを通じて最も適切に解決できるソフトウェア上の問題だと指摘しました。MemKVは、ファイルシステムのメタデータによるオーバーヘッドを回避し、大規模なKVキャッシュブロック(2MB〜64MBのテンソル)をNVMeから直接読み出します。
コストへの影響:パブリッククラウド環境のH200ノードあたり年間200万ドル以上のコストを削減します。GPUの利用率向上により、コスト削減が促進されます。
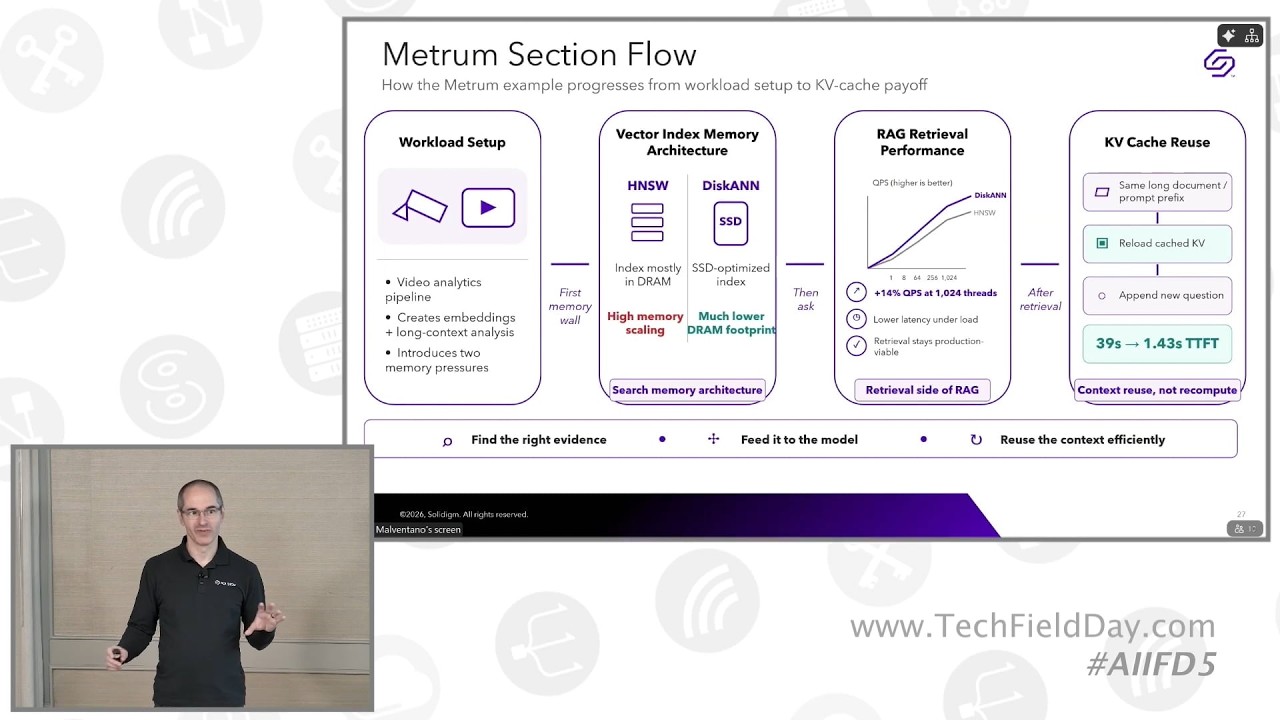
SolidigmとMetrum:AIメモリとしてのストレージ
セクション 1:RAG検索
最後のセクションでは、SolidigmとMetrumのコラボレーションを取り上げました。この評価では、RAGおよびKVキャッシュ処理向けのAIメモリとしてSSDを検証しました。
Metrumは膨大な量の動画を取り込み、詳細なメタデータを生成し、AI推論用の検索可能なデータベースを構築しています。この評価では、合成ベンチマークではなく実世界の動画パイプラインデータでSolidigm D7-PS1010 SSDを使用することにより、HNSW(メモリベースのベクトルデータベース)とDiskANN(ストレージ最適化)を比較しました。
本セクションで取り上げている項目
- Metrum AIのホワイトペーパー:"Breaking Memory Barriers in Video Analytics"
- 100万、1,000万、1億ベクトルにおけるDiskANNとHNSWの比較
- DRAM使用量を65%削減:1億ベクトル時に331GBから116GBに減少
- 初回トークン到達時間を27.4倍高速化:39.26秒から1.43秒へ
- 1,024スレッドでクエリスループットが14%向上
- 1億ベクトルまで99%以上のリコール率を維持
データセットが小さくなり、かつ並行処理数が少なくなると、HNSWがわずかながらも優位性を示しました。DiskANNは、並行処理数が増加するにつれて、特に実世界の動画パイプラインデータにおいて圧倒的な性能を発揮しました。ベクトル数を1億まで増加させると、DiskANNの曲線がHNSWを引き離す点に注目してください。ここでこそ、ストレージ最適化設計が真価を発揮します。
相当量のデータセットを高価なDRAMから低コストのSSDへ移行できる能力は、パフォーマンスを犠牲にすることなく大幅なコスト削減を実現する強力なメリットとなります。大規模な環境では、DiskANNがHNSWを凌駕します。
セクション 2:KVキャッシュのオフロード — 冗長な計算リソースを不要に
SSDは、ベクトルデータベースの検索だけでなく、KVキャッシュのオフロードにおいても重要な役割を果たします。Solidigmドライブ上に繰り返し実行されるクエリをキャッシュすることにより、初回トークン到達時間が大幅に短縮され、GPUによる冗長な再計算を不要にしました。
18万トークンのドキュメントにより、GPUメモリ使用率は95%まで押し上がりました。キャッシュの再利用がない場合、新しいクエリごとに毎回39秒のプリフィルコストの全部がかかります。SSDを活用したKVオフロードであれば、再アクセスされたドキュメントは約1.4秒でキャッシュから取得され、再コンピューティングのペナルティは発生しません。
本セクションで取り上げている項目
- 反復的な長文コンテキスト推論のためのKVキャッシュオフロード
- キャッシュから取得する場合のコンテキストスイッチを27.4倍高速化
- GPUサイクルを他のタスクのために解放
- 永続的なコンテキストをもつあらゆる大規模AIシステムに適用
この効率性は、何百人、何千人という同時ユーザーにサービスを提供する際に重要となります。より高速でより応答性の高いAIインタラクションを実現し、貴重なGPUコンピューティングサイクルを他のタスクのために解放します。
セクション 3:全体的な統合方法
このプレゼンテーションの締めくくりとして、AIデータパイプラインを、それを支えるインフラ層にマッピングしてみました。
生データを取り込み、データの前処理をして、学習およびファインチューニング用のデータを供給しています。推論が最終段階に位置し、KVオフロードおよびアーカイブによってループが完結します。インフラ階層は、G1(GPU HBM)から G2(ホストDRAM)、G3(ローカル SSD)、G3.5(コンテキストメモリストレージ)、G4(共有ストレージ)へと続きます。
本セクションで取り上げている項目
- AIデータパイプライン:取り込み、前処理、学習、推論、アーカイブ
- G1~G4 + G3.5層のマッピング
- D7-PS1010(ローカルおよびコンテキストパフォーマンス向け)
- D5-P5336(共有容量層向け)
- テレメトリとSolidigm AI Central Labにおけるラボ検証
製品の位置付けは明快です。Solidigm D7-PS1010は、ローカルブート、チェックポイント、および低レイテンシが重要となるG3.5コンテキスト層を処理できます。D5-P5336は、容量とTB単価が選定上特に重視されるG4共有ストレージ層の中核を担います。驚くようなことではありません。
まとめ
このイベントの締めくくりとして、ディスカッションの参加者は、デプロイメントの詳細、冷却要件、および TCPパスと比較した場合のRDMAの運用上の複雑さについて、深く掘り下げる議論を行いました。このプレゼンテーションは、Tech Field Dayの録画で引き続きご覧いただけます。
アリン・マルヴェンターノは、SolidigmのAI/SSDテクノロジストで、推論・RAG パイプライン向けのAIワークロードの分類、SSD の最適化、およびストレージパフォーマンスチューニングに中心的に取り組んでいます。彼はSSDの検証やパフォーマンス分析に携わってきたこれまでのポジションを通じて15年以上にわたり培ってきた、ストレージアーキテクチャに関する知見を発揮しています。
ディル・ラダクリシュナン氏は、MinIO の製品管理担当シニアディレクターとして、高性能オブジェトストレージおよび AIデータプラットフォームの製品戦略を主導しています。彼が中心的に取り組んでいるのは、エクサスケールAIワークロードに向けたS3互換ストレージのスケーリングと、ExaPODリファレンスアーキテクチャの開発です。
AB・ペリアサミー氏は、MinIOの共同創業者兼CTOとして、分散ストレージシステムの設計を手掛けているほか、MemKVや他の先進的なAIネイティブストレージ技術の開発を主導しています。