BaMおよびGIDSを使用したSolidigm™ SSDの性能
Solidigmのエンジニアは、BaMとGIDSを活用してGPUの稼働率を最大化し、トレーニング時間を短縮することで、データセンターにおけるデータボトルネックの解消に取り組んでいます。
Big Accelerator Memory (BaM) と GPU Initiated Direct Storage (GIDS) の概要
グラフニューラルネットワーク (GNN) の急激な成長と複雑化により、AI トレーニング基盤に対する需要は一層高まっています。IGBHのような(数十億のエッジと高次元の特徴量を含む)異種混在データセットは、ストレージとGPUメモリ間で膨大なデータ移動を必要とします。従来のストレージインフラでは、すべてのデータ転送をCPUが担うため、データボトルネックやパイプラインの停滞が生じ、GPUの稼働率低下やトレーニング時間の長期化を招きます。このボトルネックは、以下の2つのオープンソース研究プロジェクトを通じて解決されます。
1. BaM(ビッグアクセラレータ メモリ)
BaMは、従来のCPUモデルではなく、GPUがNVMe SSDとのストレージインタラクションを管理できるようにすることで、データ配置の考え方を刷新します。BaMは、カスタムのソフトウェアスタックを使用して従来のドライバをバイパスし、GPUの並列処理能力を活用してストレージデバイスからの大容量データ転送を実現します。
2. GIDS(GPU 開始ダイレクト ストレージ)
BaMを補完するのが、BaMソフトウェアアーキテクチャ上に構築されたGIDSデータローダーです。GIDSにより、GPUはストレージI/Oを直接開始し、管理することで、特にGNN AIトレーニングの要件に対処できるため、CPUの介入を完全に排除できます。BaMとGIDSを組み合わせることで、レイテンシーを最小限に抑え、スループットを最大化し、GPU に十分なデータを供給して最適な利用率を実現します。
SolidigmによるBaMおよびGIDSの評価
当社のテストで使用されているSolidigm™ D7-PS1010 SSDは、IGB異種混在データセットのような実際のGNN AI トレーニングワークロードにおいて、BaMとGIDS技術を実効的なアクセラレータとして機能させることができます。このホワイトペーパーでは、Solidigm D7-PS1010 SSDを使用して実施したBaMおよびGIDSの技術評価の結果を紹介します。
トレーニング向けアーキテクチャ
BaMとGIDS を使用したGNN トレーニングのアーキテクチャ
GIDSは、データ読み込み処理をCPUからGPUへ移行することで、GNNトレーニングを高速化するよう設計されています。従来のCPU依存型mmap(メモリマップ)方式であるディープ・グラフ・ライブラリ(DGL)などとは異なり、GIDSはBaMを活用してSolidigm D7-PS1010 SSDからGPUへ直接データ転送を行うことで、エンドツーエンドのデータロードを高速化し、GNNトレーニングの効率をさらに高めます。
図1. GIDSデータローダー
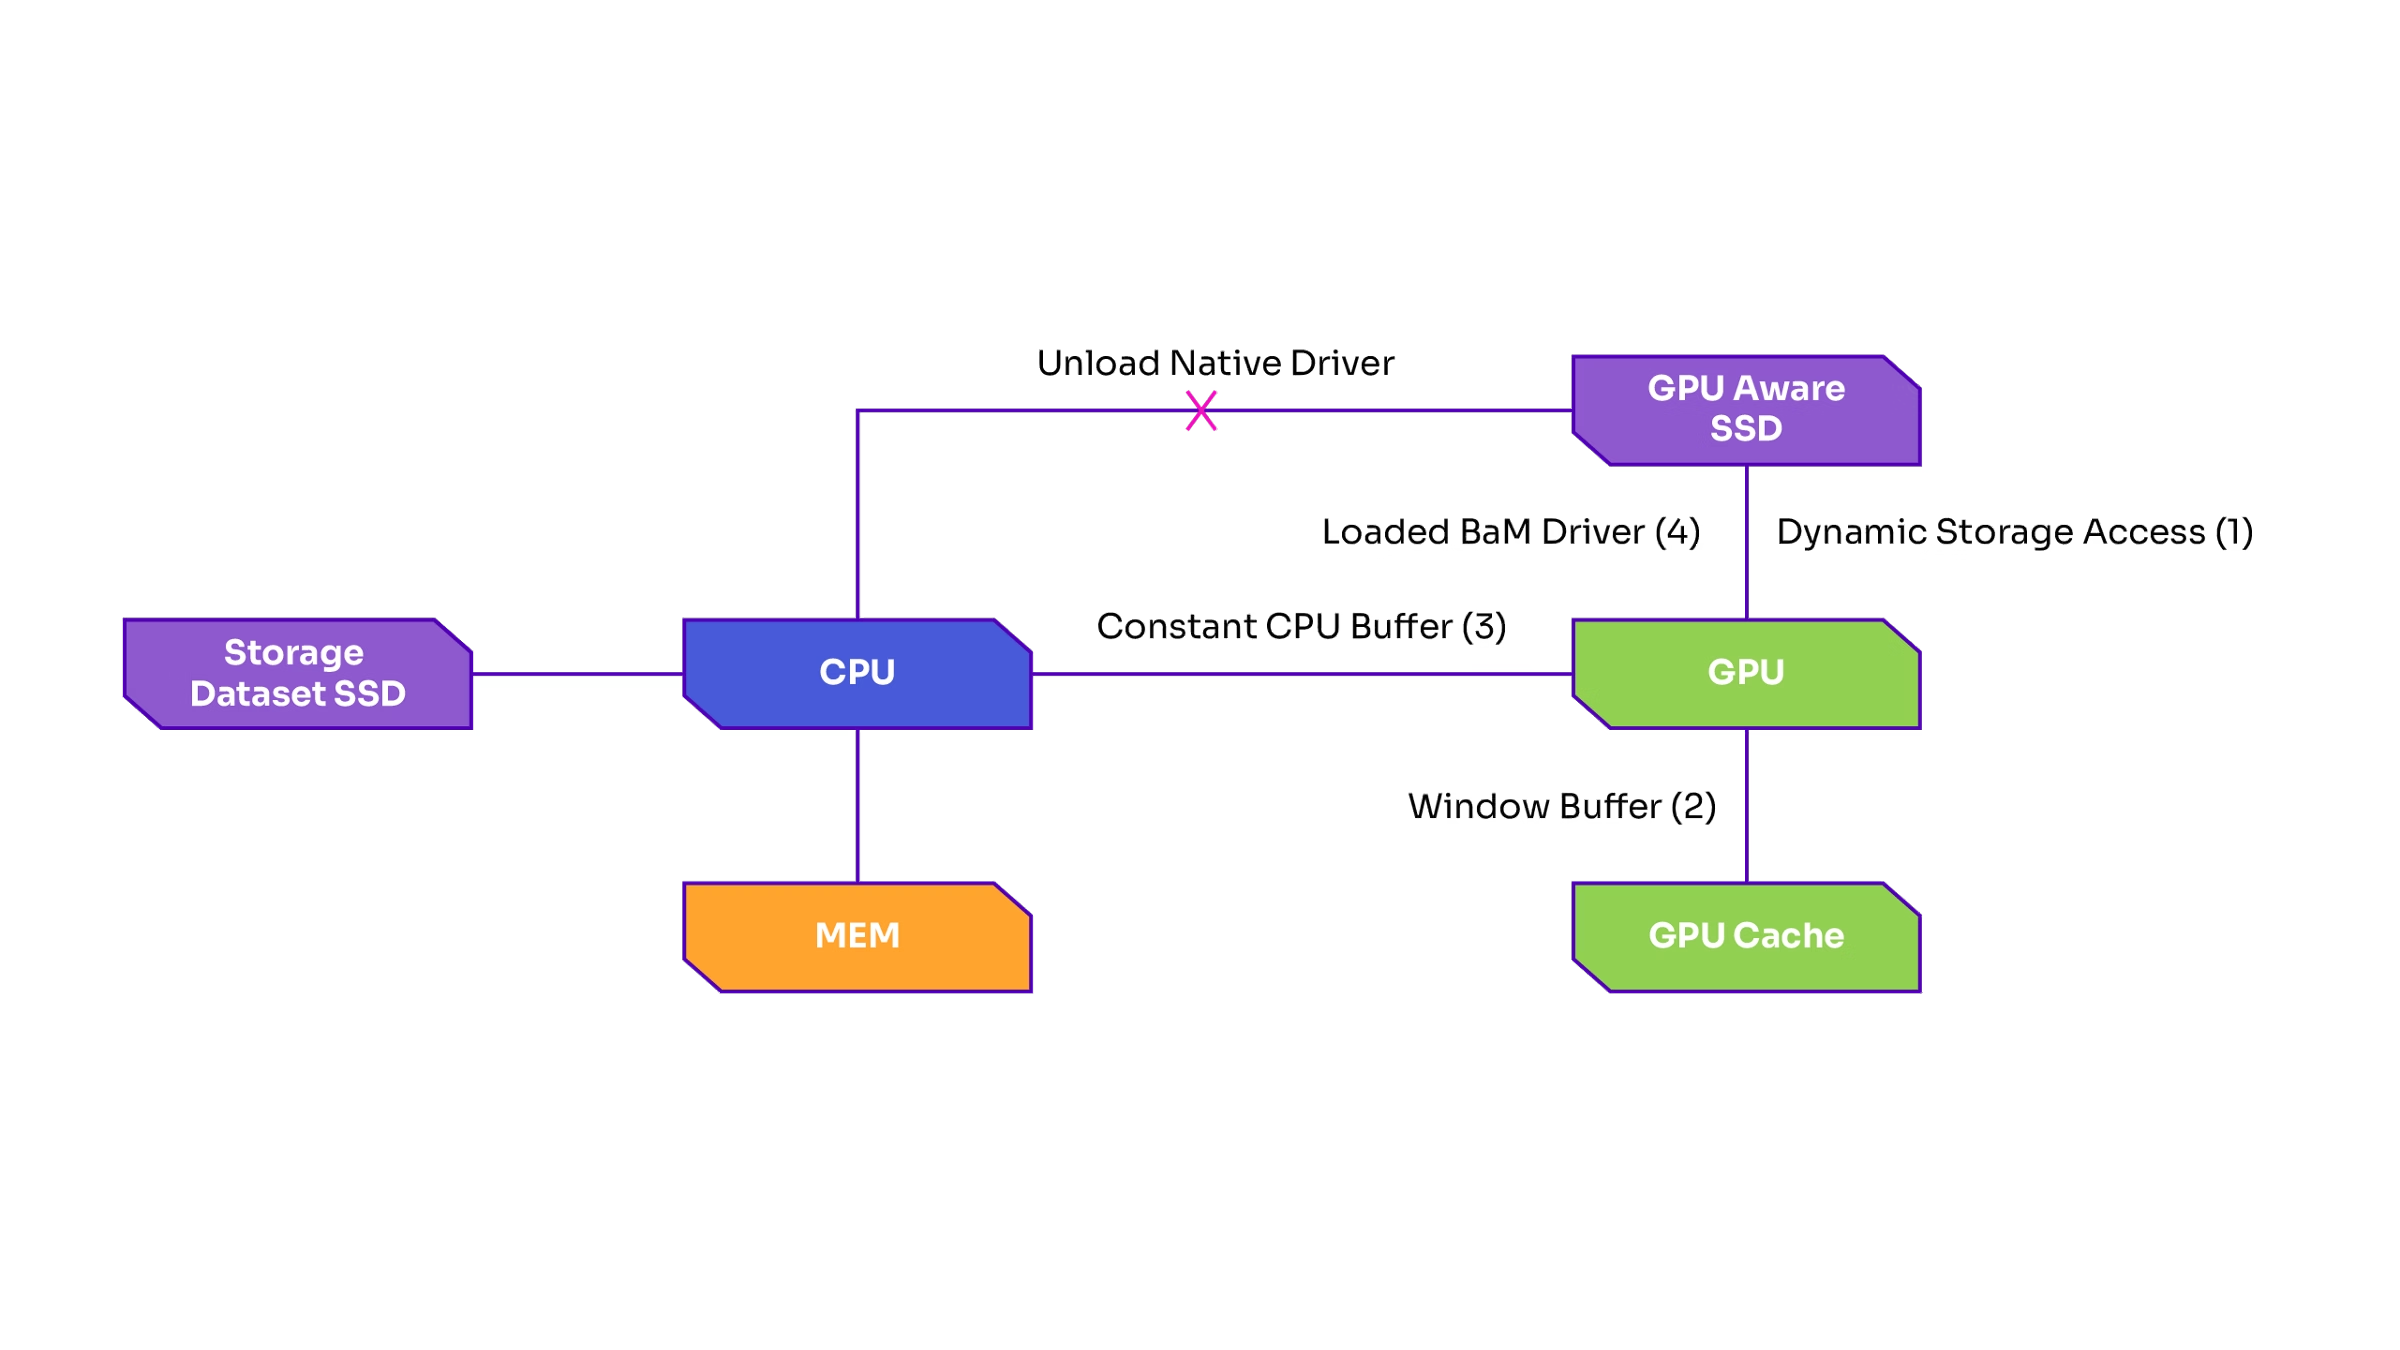
GIDSは、グラフワークロードにおけるストレージアクセスを最適化するため、次の4つの主要な技術を採用しています。
- ダイナミックストレージアクセス アキュムレータ: GPUスレッドからのストレージ要求を非同期で集約し、連続したアクセスブロックへとまとめることで、SSDの帯域幅を最大限に引き出します。
- ウィンドウバッファリング:将来のデータアクセスパターンを予測することでキャッシュ使用率を最適化し、ノード/エッジ特徴量の読み込み時に発生しがちな PCIe バスの停滞を解消します。
- 定数CPUバッファ: 固定サイズのピン留めメモリ領域を使用し、頻繁にアクセスされるデータを保持します。
- BaMソフトウェア スタック: カスタムストレージドライバーを使用して、GPUの並列処理能力を活用します。
DGL mmapを使用したGNNトレーニングのアーキテクチャ
DGL mmap(ディープ・グラフ・ライブラリのメモリマップI/O)は、従来型の CPU主導によるグラフデータの読み込み方式です。GIDSとは異なり、特に大規模なGPUワークロードにおいて、性能面でのトレードオフが生じます。
図2. ディープ・グラフ・ライブラリ・ローダー
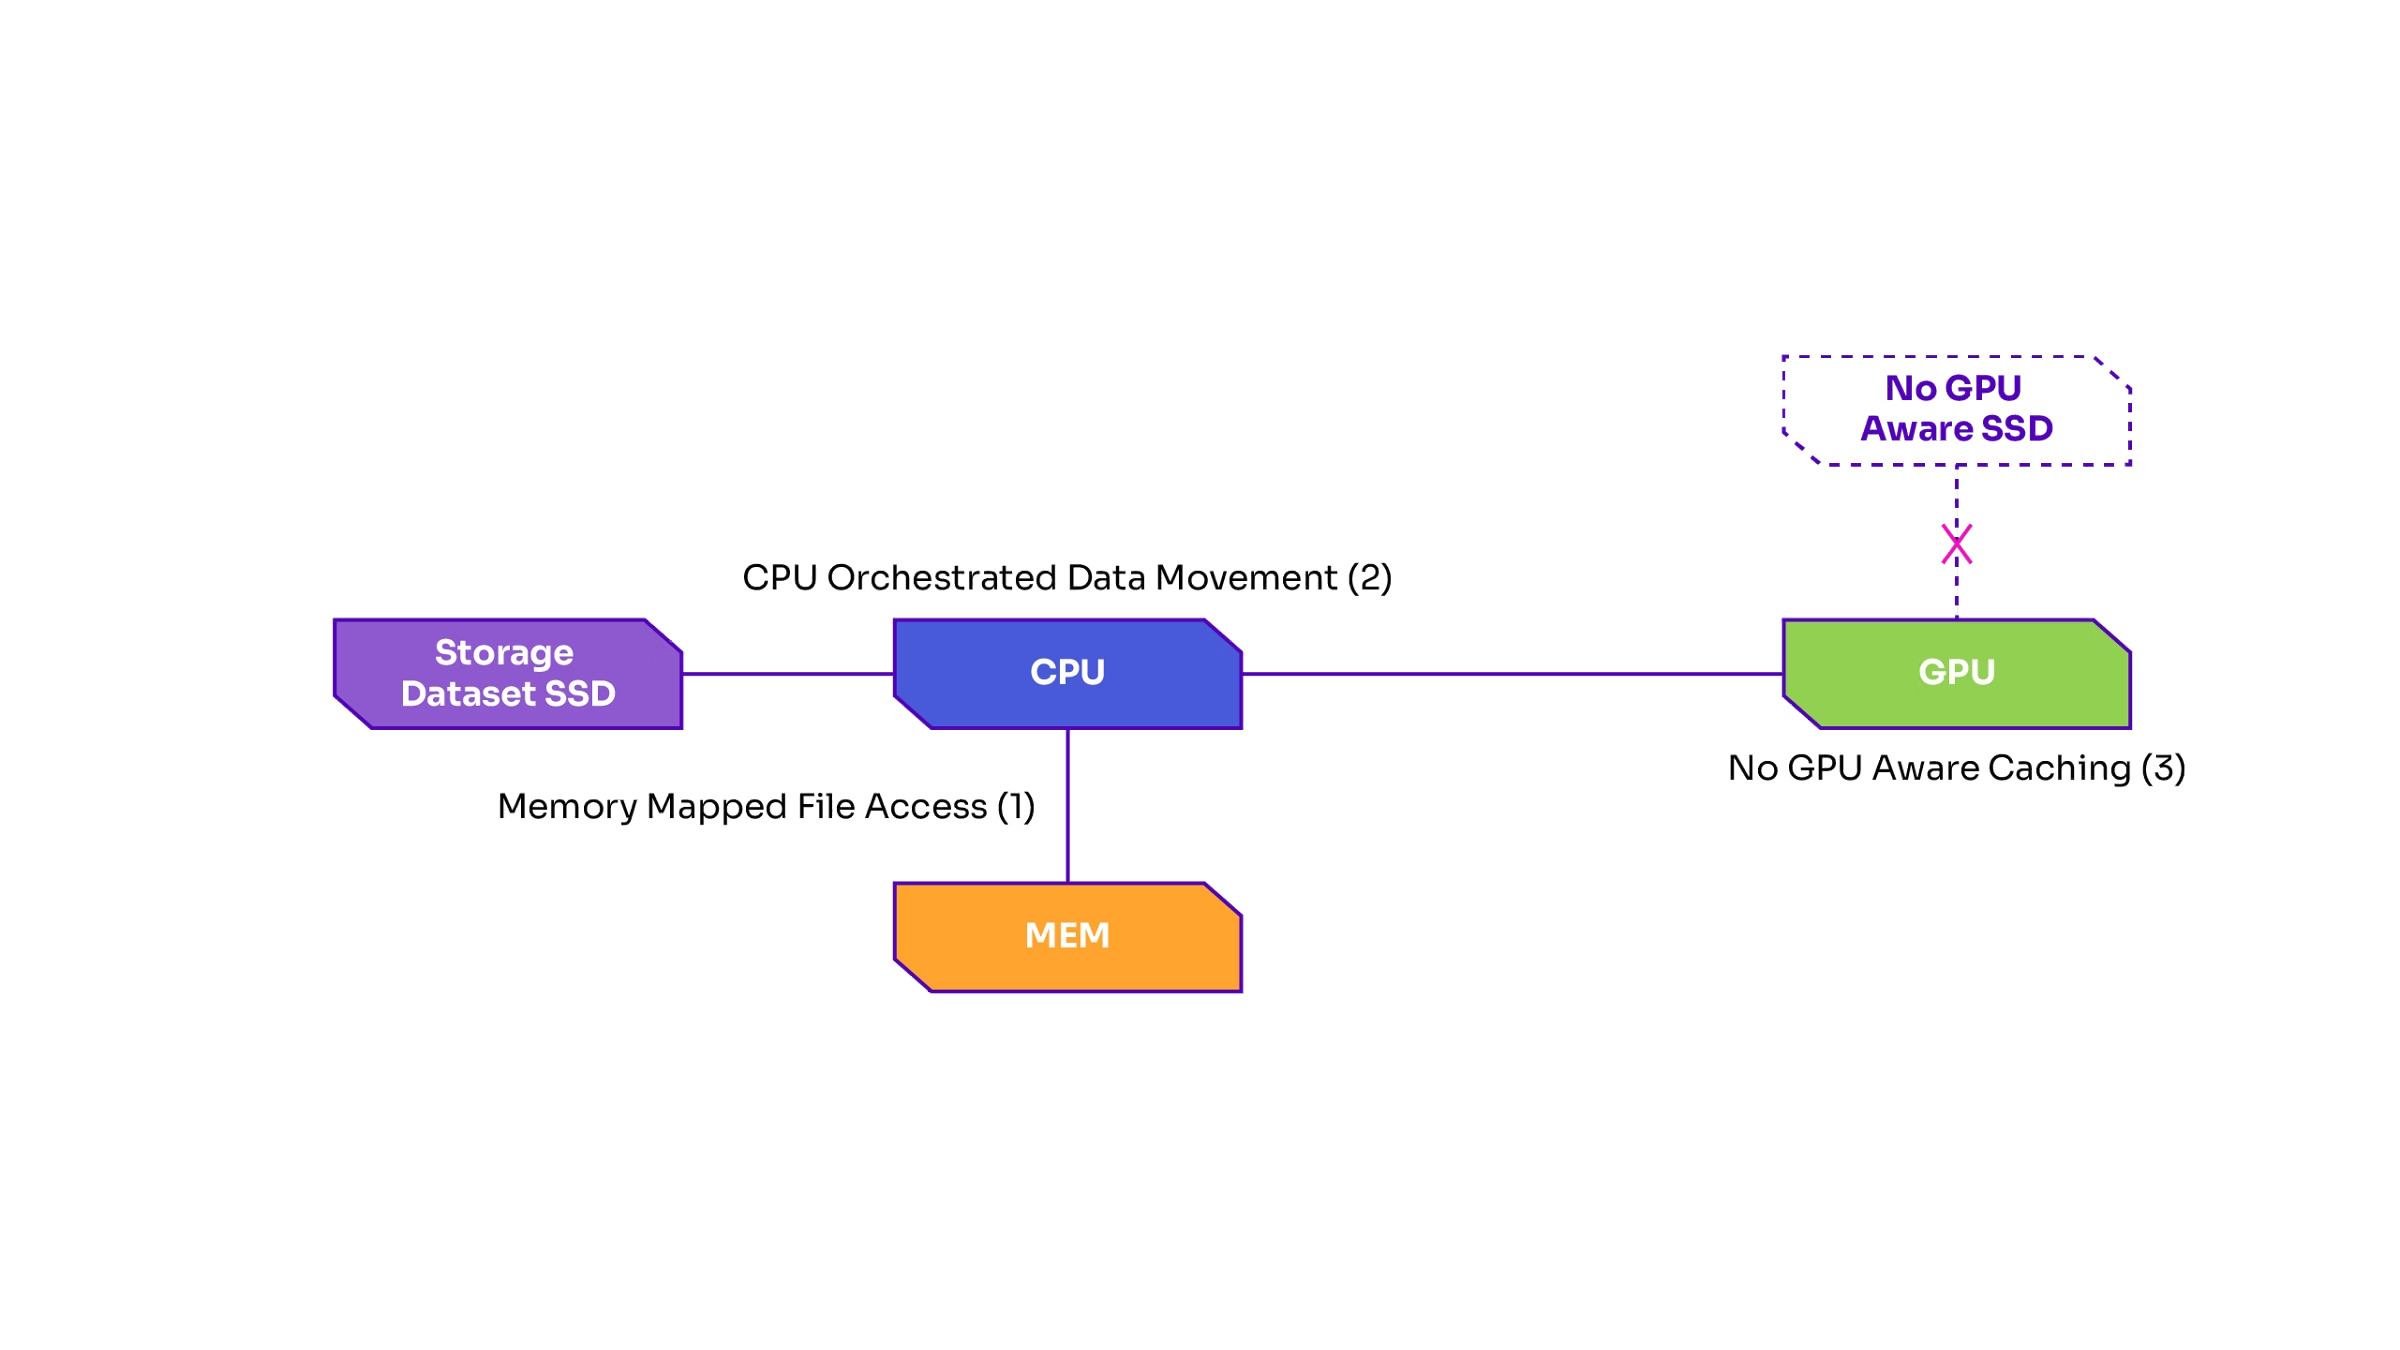
DGL mmapの主な特徴:
- メモリマップ方式によるファイルアクセス: OSレベルのmmapを使用して、グラフデータ(ノード、エッジ、特徴量)を仮想メモリにマッピングします。
- CPU主導のデータ移動: すべてのデータアクセスとGPUへのPCIe経由の転送をCPUが制御します。
- GPU対応キャッシュ機構なし: 予測型キャッシュや高度なバッファリング機構を備えていません。
テスト方法
本評価では、GIDSのGPU中心アーキテクチャ(Solidigm D7-PS1010 SSDを使用) とDGL mmapを比較し、データの読み込み効率に関するエンドツーエンド時間(100ステップ)を測定しました。GNNのトレーニングのために、Illinois Graph Benchmark(IGBH)の小規模およびフルサイズの異種混在データセットの両方を使用して検証を実施しました。
1. システム構成
ソフトウェア
- OS: Ubuntu 20.04.05 LTS
- カーネル: 5.8.0
- CUDA 12.9
- BaM
- GIDS データローダー
- Python DeepGraphLibrary
ハードウェア:
- サーバー:Supermicro SYS-421GE-TNRT
- CPU:Intel Xeon Silver 4516Y
- GPU:Nvidia L40S
- SSD:Solidigm™ D7-PS1010 (E1.S、3.84TB、PCIe 5.0 空冷)
2. ベンチマークパラメータ
- データセット:IGB異種混在データセット(スモール:1,000万エッジ)、IGBIGB異種混在データセット(フル:58億エッジ)
- ベースライン:DGL mmap(CPU中心のデータローダー)
- テストツール:GIDS データローダー
- 指標:トレーニング中の100ステップのエンドツーエンドの実行時間(秒)。
- 各ステップでは、512個のシードノードのバッチに対して、2層にわたり近傍ノードのサンプリングを実行します。
- GNNモデル:リレーショナル・グラフ・アテンション・ネットワーク(RGAT)
- ウィンドウバッファリング:8GB
- 定数CPUバッファ:データセットサイズの20%。
IGBHのMLPerf目標に合わせて、トレーニング中にベンチマークの精度を70%に設定しました。注:MLPerfは、多様なワークロードにわたって機械学習のパフォーマンスを評価するための業界標準ベンチマークのスイートであり、この基準値は、モデルが実用的な収束レベルと品質に到達したことを示します。
GIDSとBaMの有効化および実行には、公開されているコードリポジトリを使用し、データセットには Illinois Graph Benchmarkからのデータセットを使用しました。リンクについては、付録をご参照ください。
3. 結果
IGBHのスモールデータセット(1,000万エッジ)を使用したトレーニング後のモデルの精度
両方のデータローダーのトレーニング精度は、ベースライン基準値の70%を満たし、トレーニングモデルの妥当性が確認されています。
図3. IGBHのスモールデータセット(1,000万エッジ)を使用したトレーニング後のモデルの精度
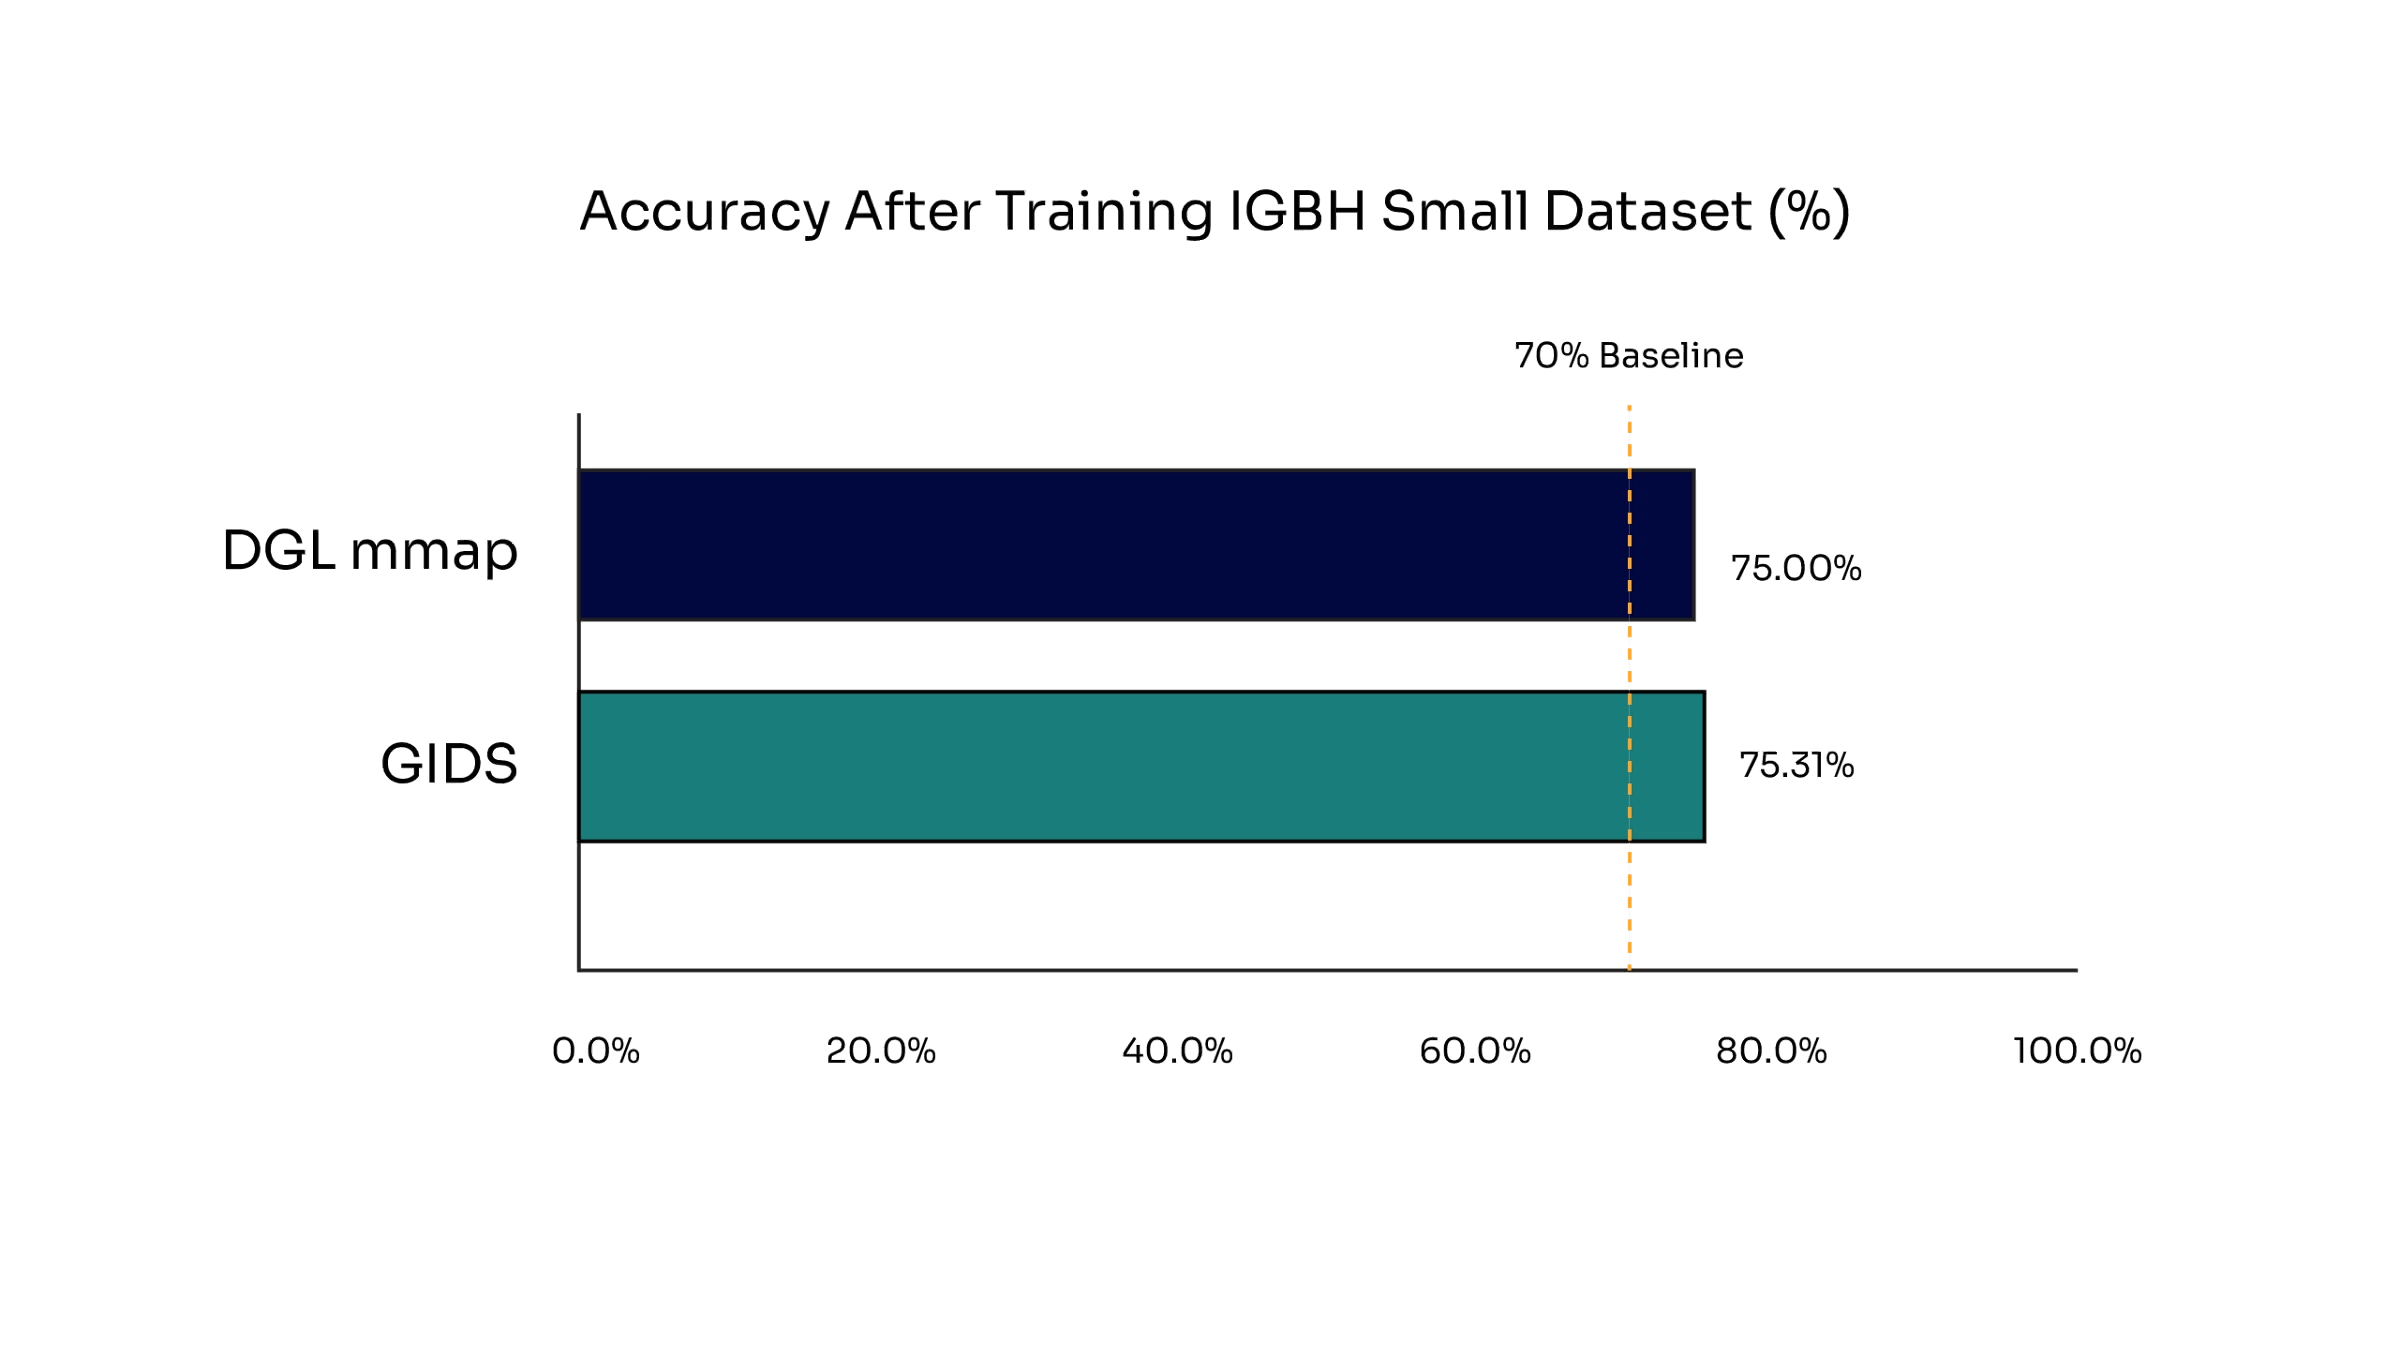
100ステップで単一のSolidigm D7-PS1010ドライブを使用したIGBHスモールデータセット(1,000万エッジ)のE2E時間
Solidigm D7-PS1010 PCIe 5.0 SSDを使用すると、GIDSはオーバーヘッドを最小限に抑え、並列処理を活用することで、小規模なグラフの読み込み時間をほぼ2倍短縮します。
図4. IGBHスモールデータセットのE2E時間(1,000万エッジ)
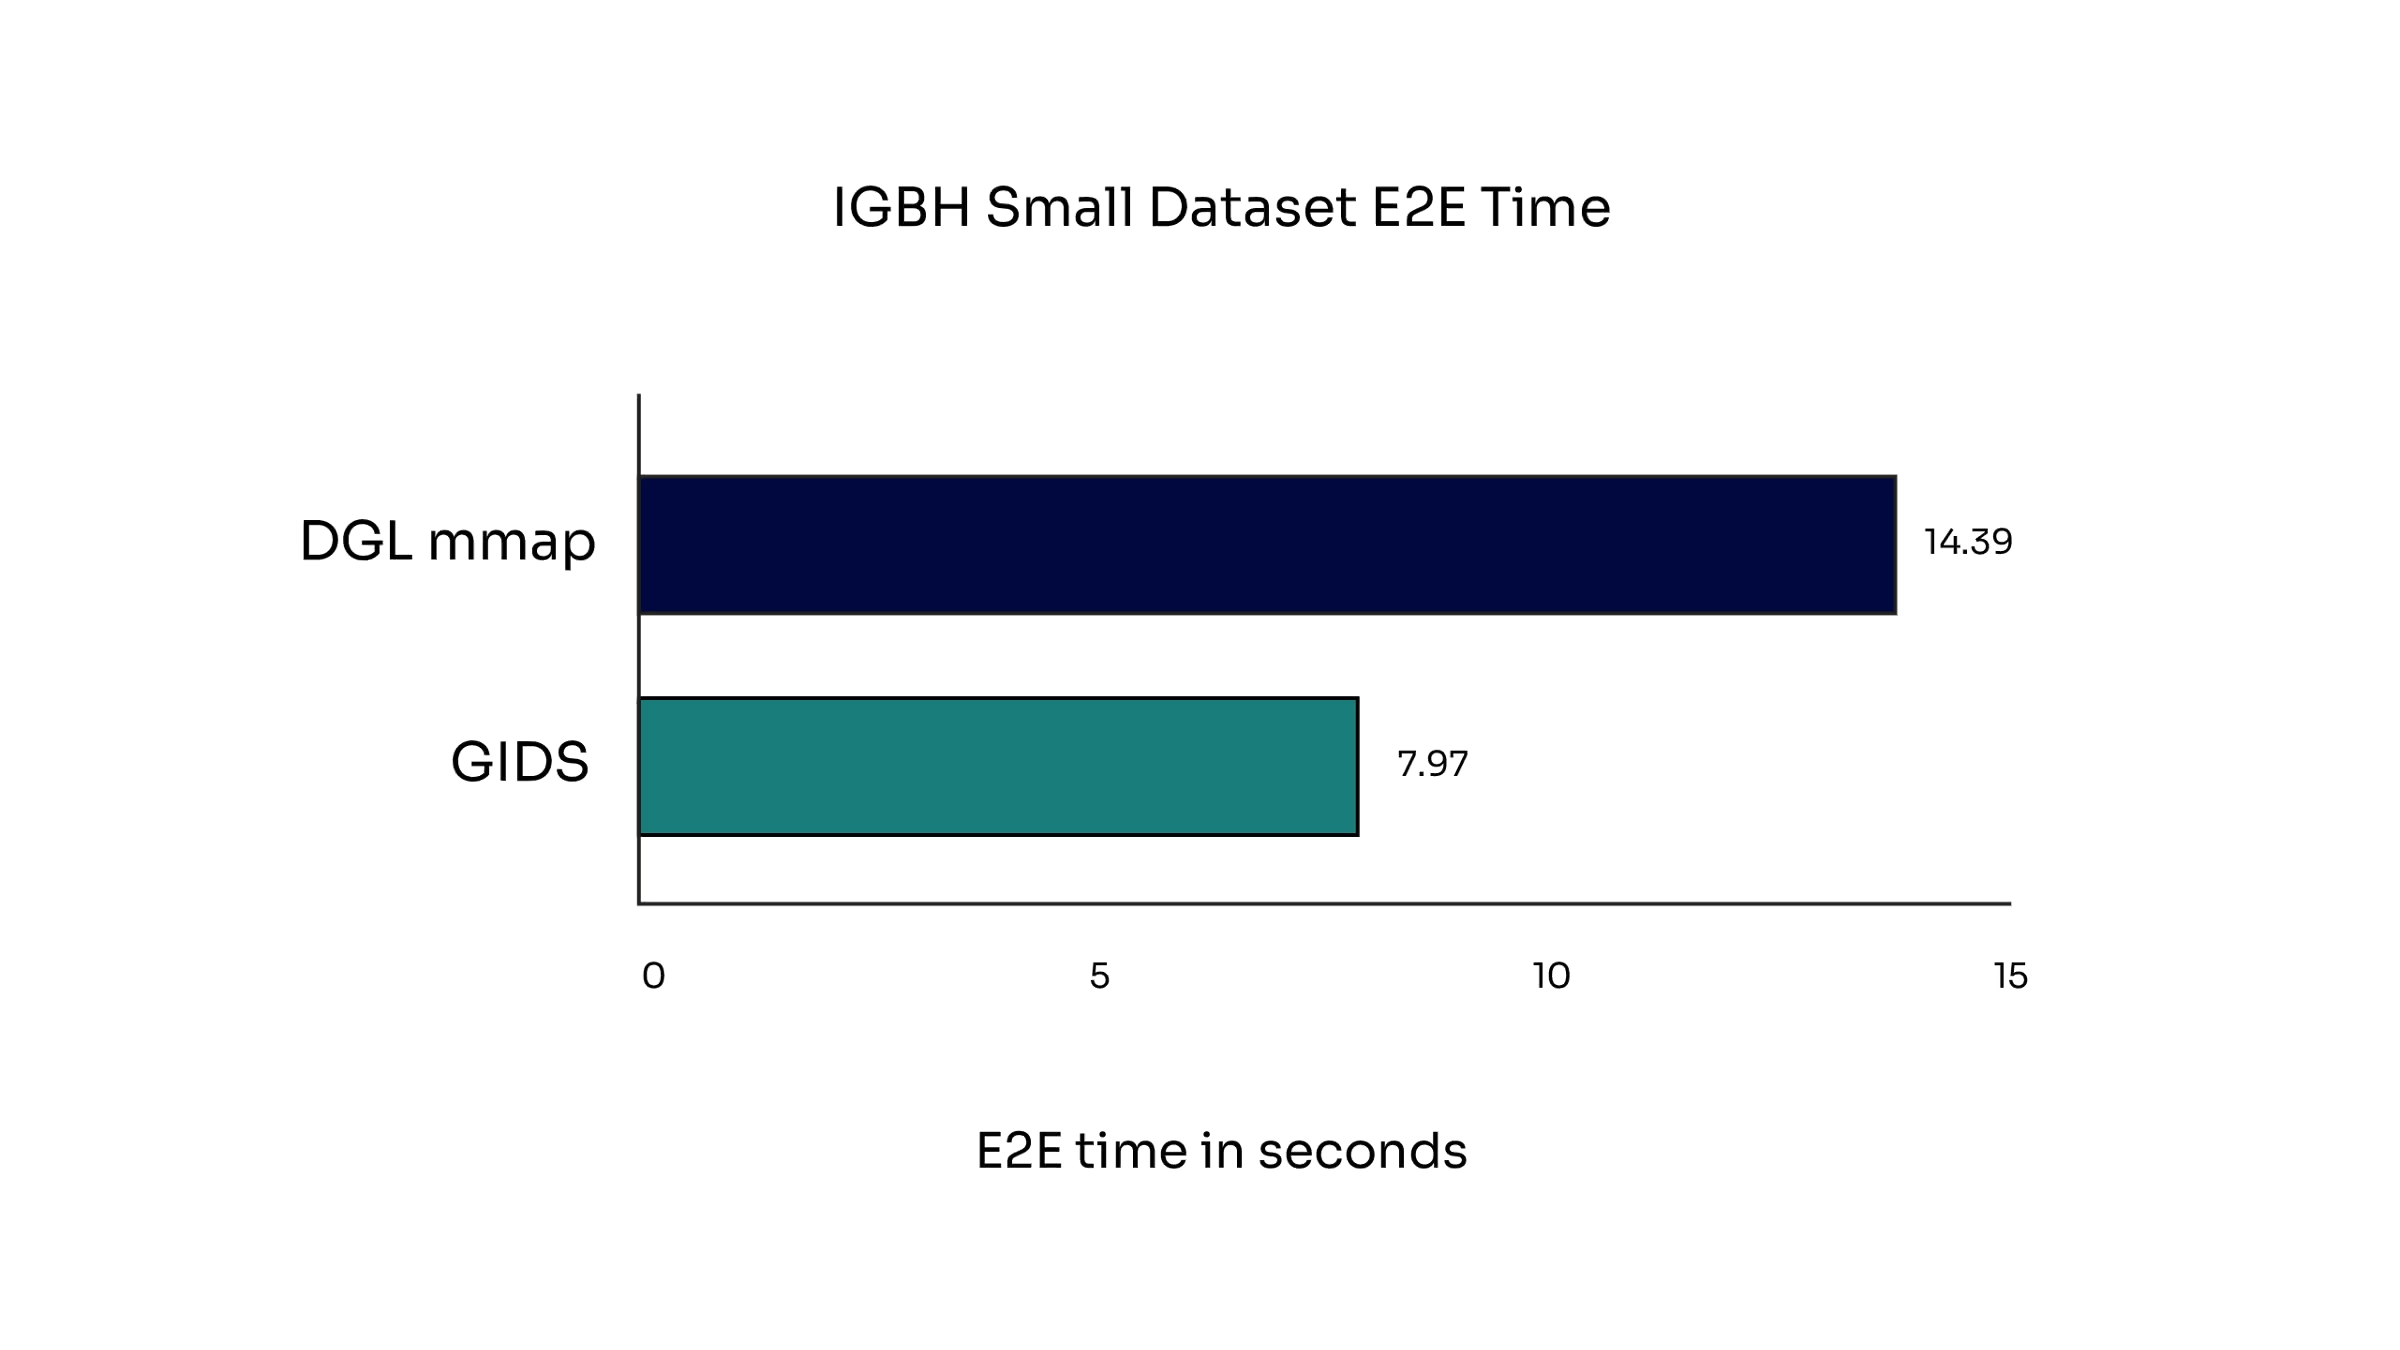
IGBHフルデータセット(58億エッジ)を使用したトレーニング後のモデルの精度
両方のデータローダーにおける学習精度は、ベースライン基準値である70%を満たしており、学習済みモデルの妥当性が確認されています。
図5. IGBHフルデータセット(58億エッジ)を使用したトレーニング後のモデルの精度
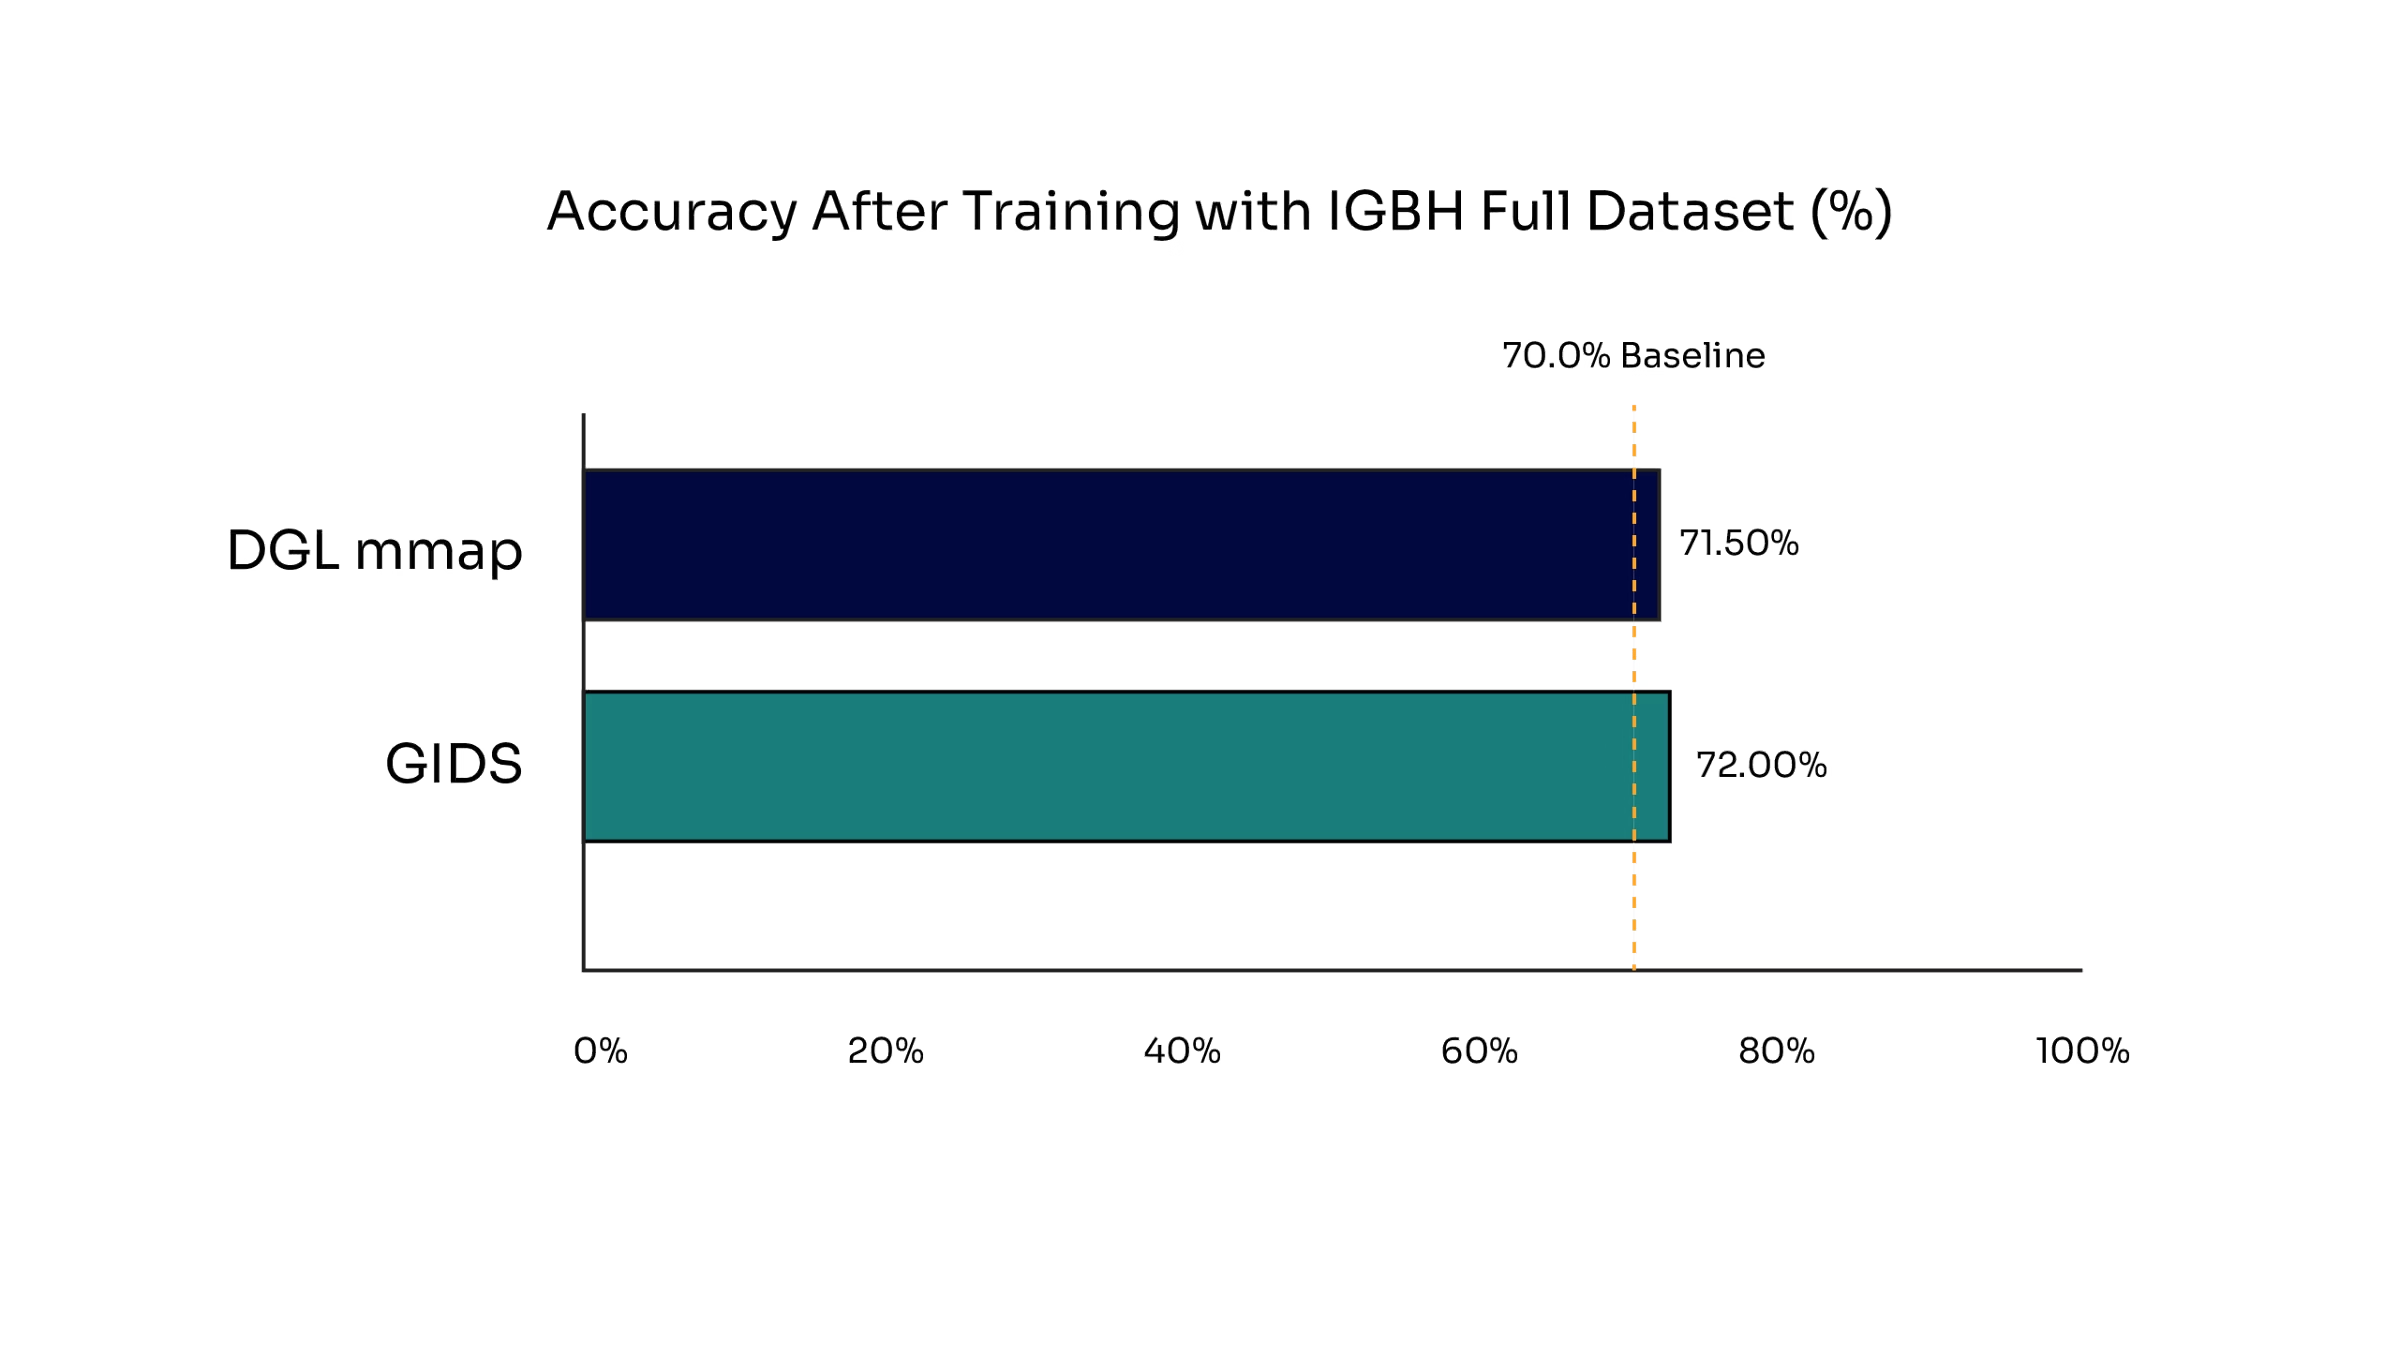
100ステップで単一のSolidigm D7-PS1010ドライブを使用したIGBHフルデータセット(58億エッジ)のE2E時間
GIDSは、エッジ数の増加に伴い、DGL mmapと比較してほぼ9倍のスケーリング性能を示します。
図6. IGBHフルデータセットのE2E時間(58億エッジ)
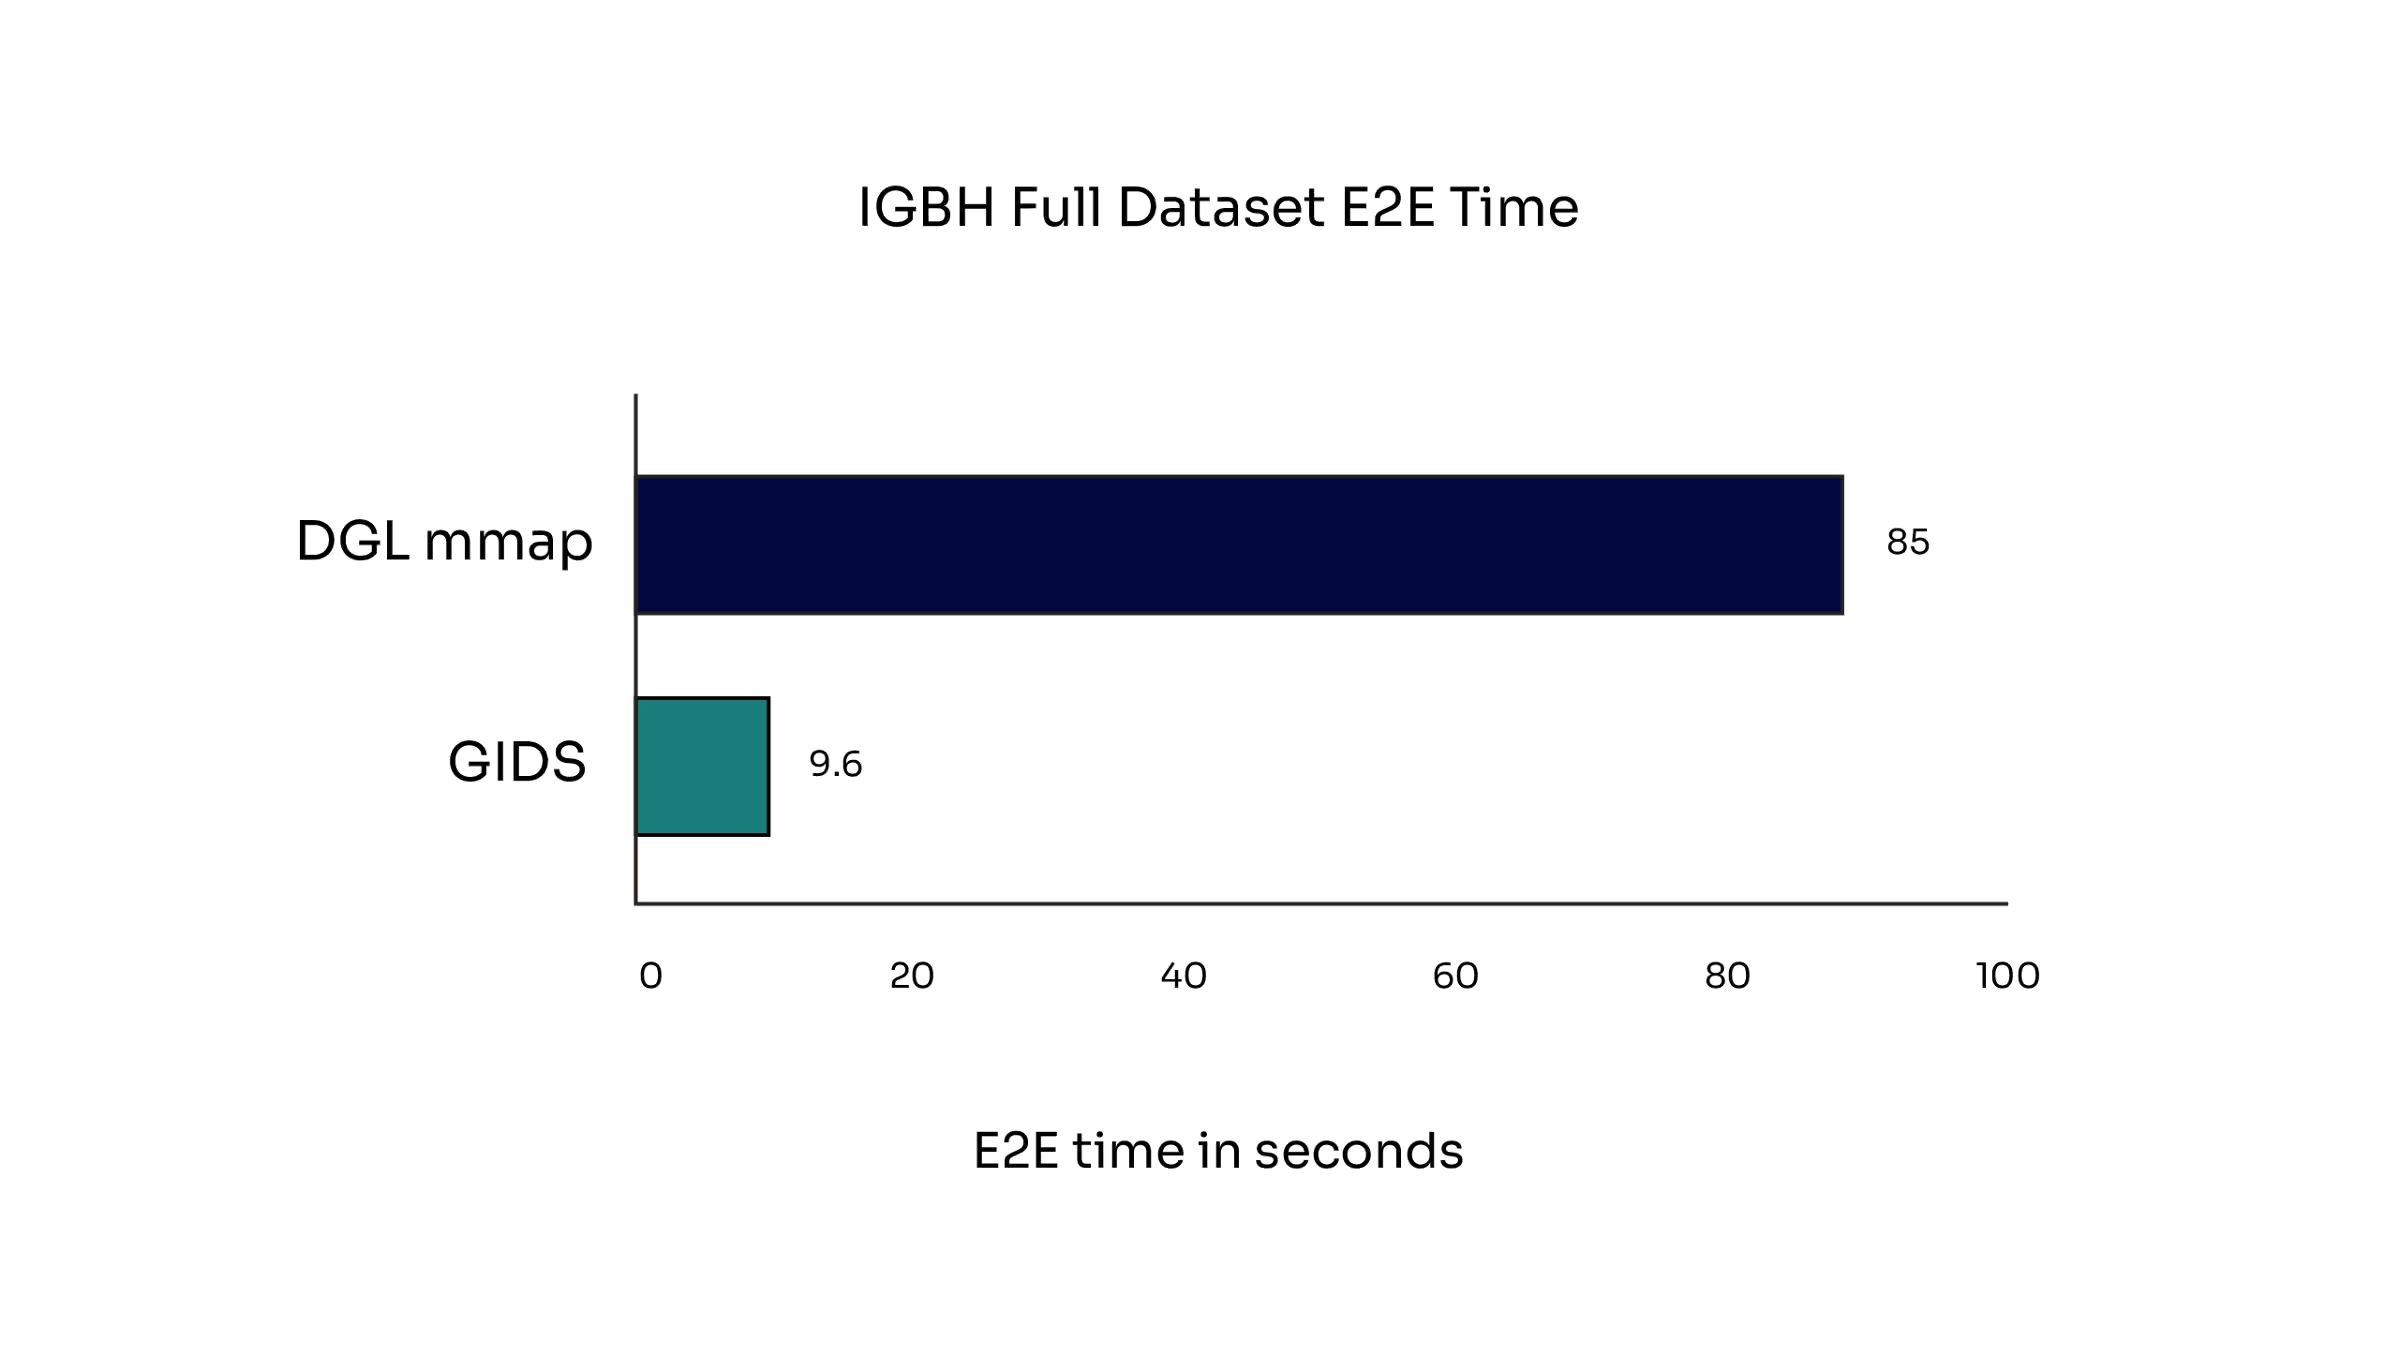
IGBH データセットでBaMおよびGIDSを使用した際に達成されたGPUキャッシュ指標
| データセット | キャッシュヒット率 | キャッシュミス率 |
|---|---|---|
| スモール | 77.49% | 22.51% |
| フル | 10.80% | 89.20% |
表1. IGBHデータセットでBaMおよびGIDSを使用した際に達成されたGPUキャッシュ指標
表1では、IGBH異種混在グラフの2つのデータセット規模(スモールとフル)を使用して、GIDSデータローダーでGNNを学習した際のGPUキャッシュ性能指標を比較しています。対象となる指標は次のとおりです。
- キャッシュヒット率:BaM環境下で、SSDではなくソフトウェアキャッシュ(GPUウィンドウバッファおよび固定CPUバッファを含む多層キャッシュ)から取得された特徴量リクエストの割合。
- キャッシュミス率:ソフトウェアキャッシュ内にデータが存在せず、BaM 環境下で SSD から取得する必要があったリクエストの割合。
キャッシュのヒット率とミス率は、スモールデータセットとフルデータセットで大きく異なり、小規模な実行ではヒット率77%、フルデータセットでは約10%となっています。ただし、この差がエンドツーエンド時間の大幅な差に直結するわけではありません。トレーニングループではGPU計算が支配的であり、I/Oと重なって実行されるためです。データは事前にストリッピングされ、BaMを通じてプリフェッチ付きでアクセスされるため、計算中にSSD読み取りが効率的に処理され、キャッシュミスが全体の実行時間に与える影響は抑えられます。
なお、Deep Graph Library(DGL)方式は、GPU向けソフトウェアキャッシュ機構やSSDを考慮したプリフェッチ機構を備えておらず、ソフトウェアキャッシュアクセスを報告する仕組みがないため、この表には含まれていません。
まとめと今後の方向性
Solidigm D7-PS1010 SSDは、GNN トレーニング向けのBaMおよびGIDSテクノロジーと組み合わせることで、パフォーマンスの向上を実現します。
- Solidigm D7-PS1010 SSDの高速シーケンシャルおよびランダム読み取り機能を活用して、BaMおよびGIDSとの統合により、大規模なグラフデータセットの取り込みと準備が加速します。
- GIDSはデータロード時間を大幅に短縮し、従来のCPU依存型DGL mmapアプローチと比較して、IGBHスモールデータセット(1,000万エッジ)において最大2倍の高速化を実現します。
最大規模の評価データセットであるIGBHフルデータセット(58億エッジ)においても、GIDSは従来の手法と比べて9倍高速なデータロード性能を維持します。BaMおよびGIDSに関する当社の取り組みは、将来のストレージ構成に向けたSolidigm D7-PS1010 SSDの実用化と展開に向けた確実な基盤を築くものです。
Ashwin Pai(アシュウィン・パイ)は、Solidigmのシステム検証エンジニアで、ソフトウェア、ハードウェア、システムエンジニアリング分野で10年近くの経験を有しています。AIやデータ集約型ワークロード向けに最適化されたプラットフォームを含む多様な環境で、次世代SSD技術の検証に注力しています。Ashwin は、先進的なAI手法や革新的な技術を活用しながら、部門横断的なチームと連携し、AI主導環境におけるSolidigmSSD の性能向上に取り組んでいます。VES工科大学電子工学の学士号を取得し、ノースカロライナ州立大学でコンピュータ工学の修士号を取得しています。
Akhil Srinivas(アキール・シュリニヴァース)は、Solidigmの電気・システムエンジニアです。業界をリードするエコシステムベンダーと連携し、最先端のストレージソリューション向けにSolidigm SSDの検証を行っています。新たに台頭するAI技術や先進的なイノベーションを活用し、次世代プラットフォームにおける重要コンポーネントとしてSolidigm SSDを位置づけるとともに、AI分野でのパートナーシップ強化に貢献しています。仕事以外では料理の探求に没頭し、全米で人気のフードトラックやレストランを訪れています。Akhilは、インドのRV工科大学で電気通信工学の学士号を取得し、カリフォルニア大学デービス校で電気工学とコンピュータ工学の修士号を取得しています。
Solidigm D7 PS1010 SSD E1.Sフォームファクターについて
Solidigm D7-PS1010 E1.S は、AI ワークロード向けの主要なSSDです。 E1.S D7-PS1010 は、特定のAIサーバー環境向けに最適化された以下のフォームファクターで提供されています。
| フォームファクター | 容量 | |||
|---|---|---|---|---|
| 3.84TB | 7.68TB | 3.84TB | 7.68TB | |
| 9.5mm |
|
|
|
|
| 15mm |
|
|
|
|
BaMおよびGIDSのツールとスクリプトについては、以下のリンクを参照してください。
©2026, Solidigm. 「Solidigm」は、米国、中華人民共和国、シンガポール、日本、欧州連合、英国、メキシコ、その他の国における、SK hynix NAND Product Solutions Corp (商号: Solidigm)の登録商標です。
その他の社名、製品名などは、一般に各社の表示、商標または登録商標です。
Solidigmは、事前の通知なく、仕様および製品説明をいつでも変更する場合があります。
テストでは、特定のシステムでの個々のテストにおけるコンポーネントのパフォーマンスを文書化しています。
ハードウェア、ソフトウェア、システム構成などの違いにより、実際のパフォーマンスは掲載されたパフォーマンステストや評価とは異なる場合があります。
購入を検討される場合は、ほかの情報も参考にして、パフォーマンスを総合的に評価することをお勧めします。
文書化された結果は暫定的なものであり、情報提供のみを目的としています。これらの数値や記述は最終的なものでも公式なものでもありません。
ドライブはエンジニアリングサンプルとみなされます。本番環境に関するガイダンスについては、ロードマップを参照してください。