高性能ストレージによるAIの加速
CPUのボトルネック解消、GPUワークロードの効率維持、アーキテクチャーの活用によって、AIの加速を損なうことなく、スケーラブルでコスト効率の高いAIインフラを実現する方法についてご紹介します。
GPUDirect® StorageとNVIDIA Bluefield®-3データ処理ユニット駆動のNVMe エミュレーションを含むNVIDIA® Magnum IOアーキテクチャー搭載、Solidigm™ SSD
CPU-GPUデータパスと比較した、NVIDIA GDS搭載Solidigm SSDのパフォーマンス
GPUとストレージのボトルネック
現代のAIワークロードが要求するのは、これまでにないデータスループットと、大規模データセットへの低レイテンシーアクセスです。NVMe SSDとGPU間のデータ移動をCPUに依存する従来のストレージアーキテクチャーでは、GPUの演算能力に追いつくのは困難です。Solidigm™ D7-PS1010などのデータセンター向けSSDは、最大14,500 MB/秒の連続読み出し速度を実現しますが、その潜在能力を最大限に引き出すには、GPUがローカルおよび分散型リモートシステム間でストレージと連携する方法について再考する必要があります。
NVIDIA GPUDirect Storage(GDS)
NVIDIA GPUDirect Storage(GDS)は、GPUとNVMe SSD間の直接メモリアクセス(DMA)を可能にすることで、CPUのボトルネックを解消します。NVIDIA Magnum IO SDKの一部であるGDSは、CUDAなどのフレームワークと連携してCPU/RAMデータステージングをバイパスすることでレイテンシーを低減し、重要な管理タスクで使えるようにCPUリソースを解放します。
NVIDIA DPUによるリモートストレージへのGDS拡張
GDSはローカルストレージへのアクセスを最適化しますが、現代のAIインフラでは、ストレージを個々のGPUノードから切り離すスケーラブルなソリューションが求められています。NVIDIAデータ処理ユニット(DPU)は、ストレージとネットワークタスクをオフロードすることでこのギャップを埋め、DPUのSNAPフレームワークを使用したリモートNVMe-over-Fabric(NVMe-oF)エミュレーション1を実現します。Solidigm PCIe Gen5 SSDは、高速ファブリックを介してリモートドライブとして仮想化できるため、GPUが分散ストレージプールにアクセスすることが可能となります。このアーキテクチャーは、GDSのダイレクトデータパスとDPUによるファブリックの拡張性を組み合わせ、AIワークロード向けの統合ソリューションを実現します。
システム構成
ハードウェア
- サーバー:Supermicro ARS-111GL-NHR
- CPU/GPU:- Grace Hopper 200
- SSD:Solidigm™ D7-PS1010(E1.S、7.68TB、PCIe 5.0)、Solidigm™ D7-P5520(U.2、7.68TB、PCIe 4.0)
ソフトウェア
- OS: Ubuntu 22.04.5 LTS
- カーネル:6.8.0-1021-nvidia-64k
- Cuda: 12.6
- GDSIO: 1.11
方法
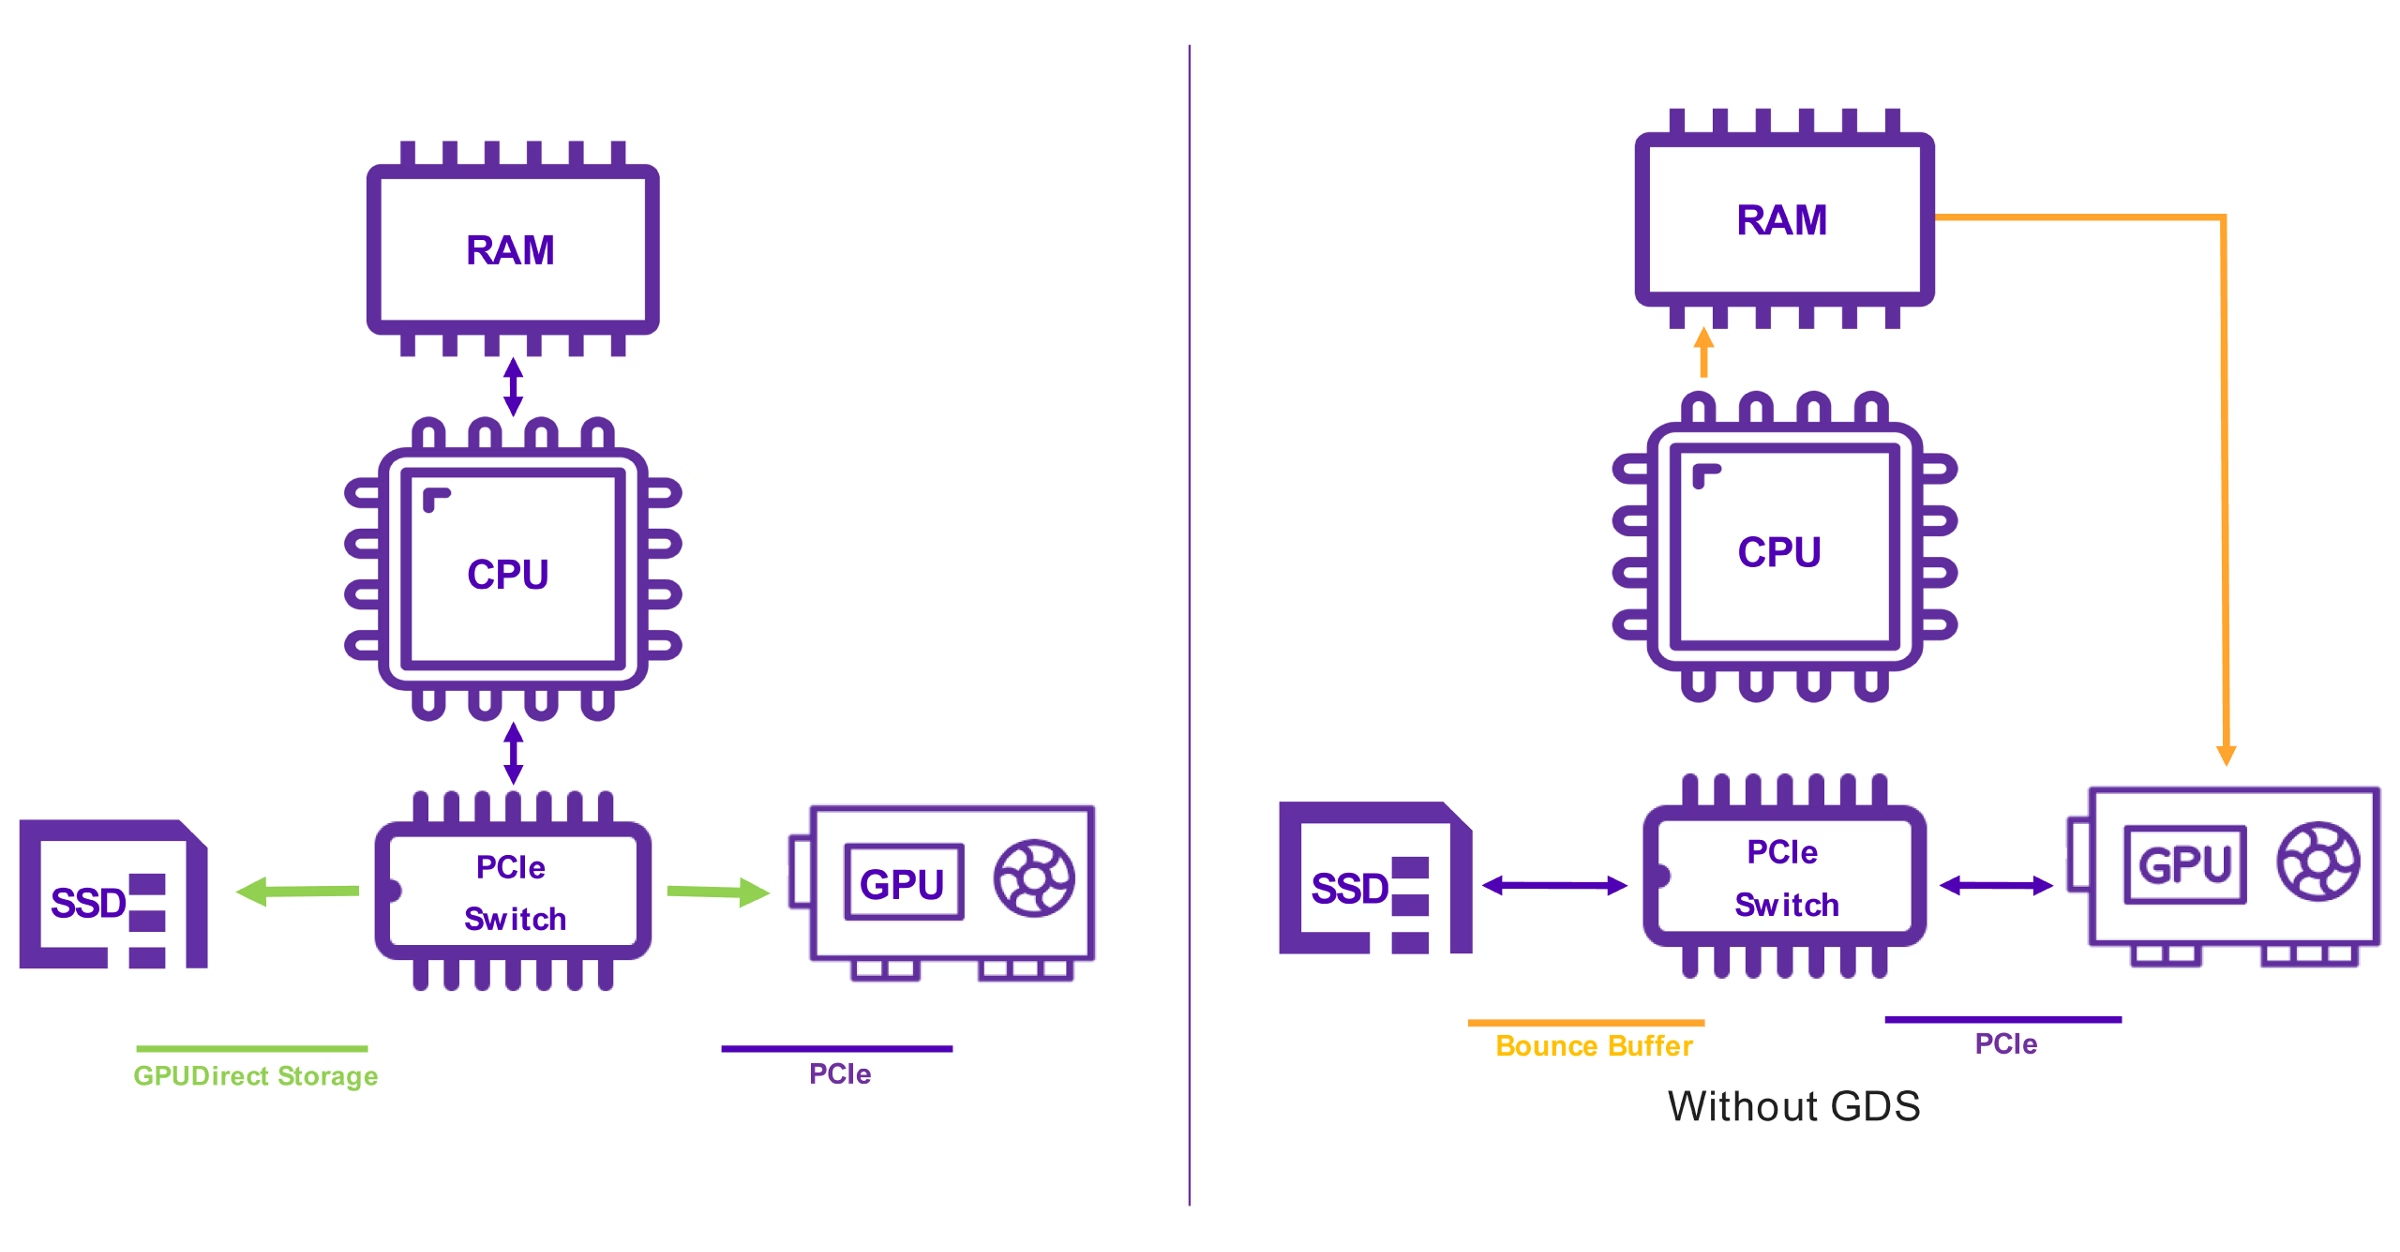
2つのデータパスを比較
1. GDSパス:GPUとSSD間のダイレクトDMA転送。
2. 従来型パス:データはSSD→CPU/RAM→GPUの順に移動
図1. GPUとSSD間の直接DMA転送を伴うGDSパスと、図2の比較。GDSなしの従来型パス
ベンチマークパラメータ
- ブロックサイズ:64KiB、128KiB、512KiB、1024KiB、4096KiB
- ワークロード:連続読み出し
- キュー深度(QD):24/32
- 指標:スループット(GB/s)、CPU/USR使用率(%)
- ランタイム:45秒
- サーバー消費電力(ワット)
結果
| ドライブ | D7-P5520 - 7.68TB(PCIe Gen4) | |||
|---|---|---|---|---|
| テスト | GDSパス | CPU-GPU(従来型パス) | ||
| IOサイズ | スループット(GiBps) | CPU_USR(%) | スループット(GiBps) | CPU_USR(%) |
| 64KiB | 4.35 | 0.14 | 4.30 | 0.92 |
| 128KiB | 5.21 | 0.08 | 5.18 | 0.56 |
| 512KiB | 6.50 | 0.03 | 6.51 | 0.20 |
| 1024KiB | 6.59 | 0.02 | 6.64 | 0.12 |
| 4096KiB | 6.62 | 0.01 | 6.63 | 0.06 |
表1. Solidigm D7-P5520 FW:9CV10330(U.2、7.68TB、PCIe 4.0)
| ドライブ | D7-PS1010 - 7.68TB(PCIe Gen5) | |||
|---|---|---|---|---|
| テスト | GDSパス | CPU-GPU(従来型パス) | ||
| IOサイズ | スループット(GiBps) | CPU_USR(%) | スループット(GiBps) | CPU_USR(%) |
| 64KiB | 12.38 | 0.51 | 12.70 | 3.15 |
| 128KiB | 13.20 | 0.27 | 13.48 | 1.64 |
| 512KiB | 13.41 | 0.04 | 13.48 | 0.46 |
| 1024KiB | 13.48 | 0.02 | 13.48 | 0.29 |
| 4096KiB | 13.48 | 0.01 | 13.48 | 0.14 |
表2. Solidigm D7-PS1010 FW:G77YG100(E1.S、7.68TB、PCIe 5.0)
図3. Solidigm D7-P5520のスループット
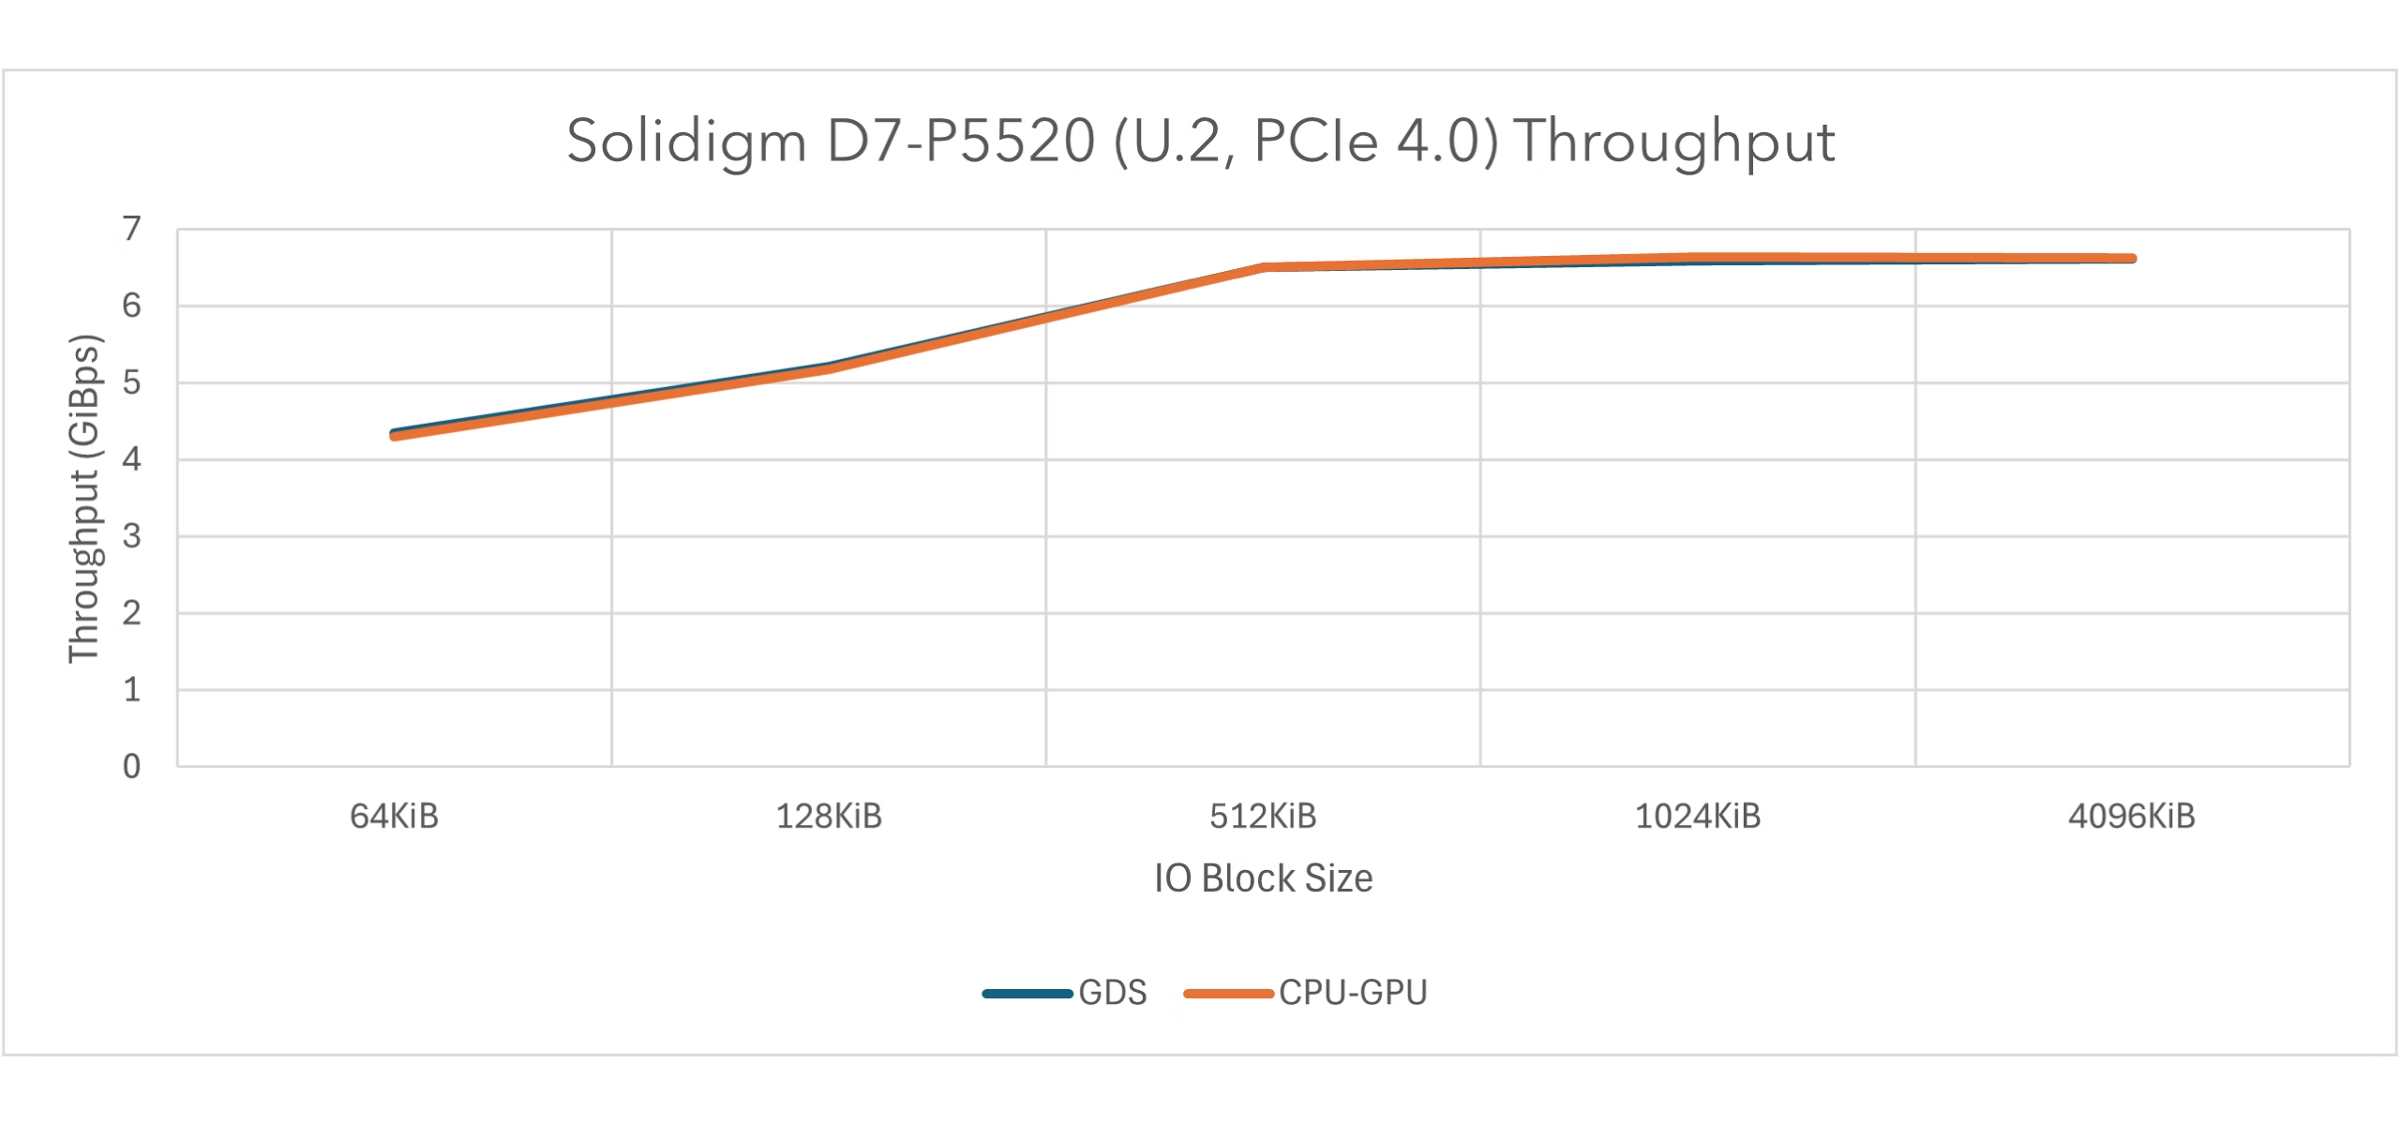
図4. Solidigm D7-P5520の使用率
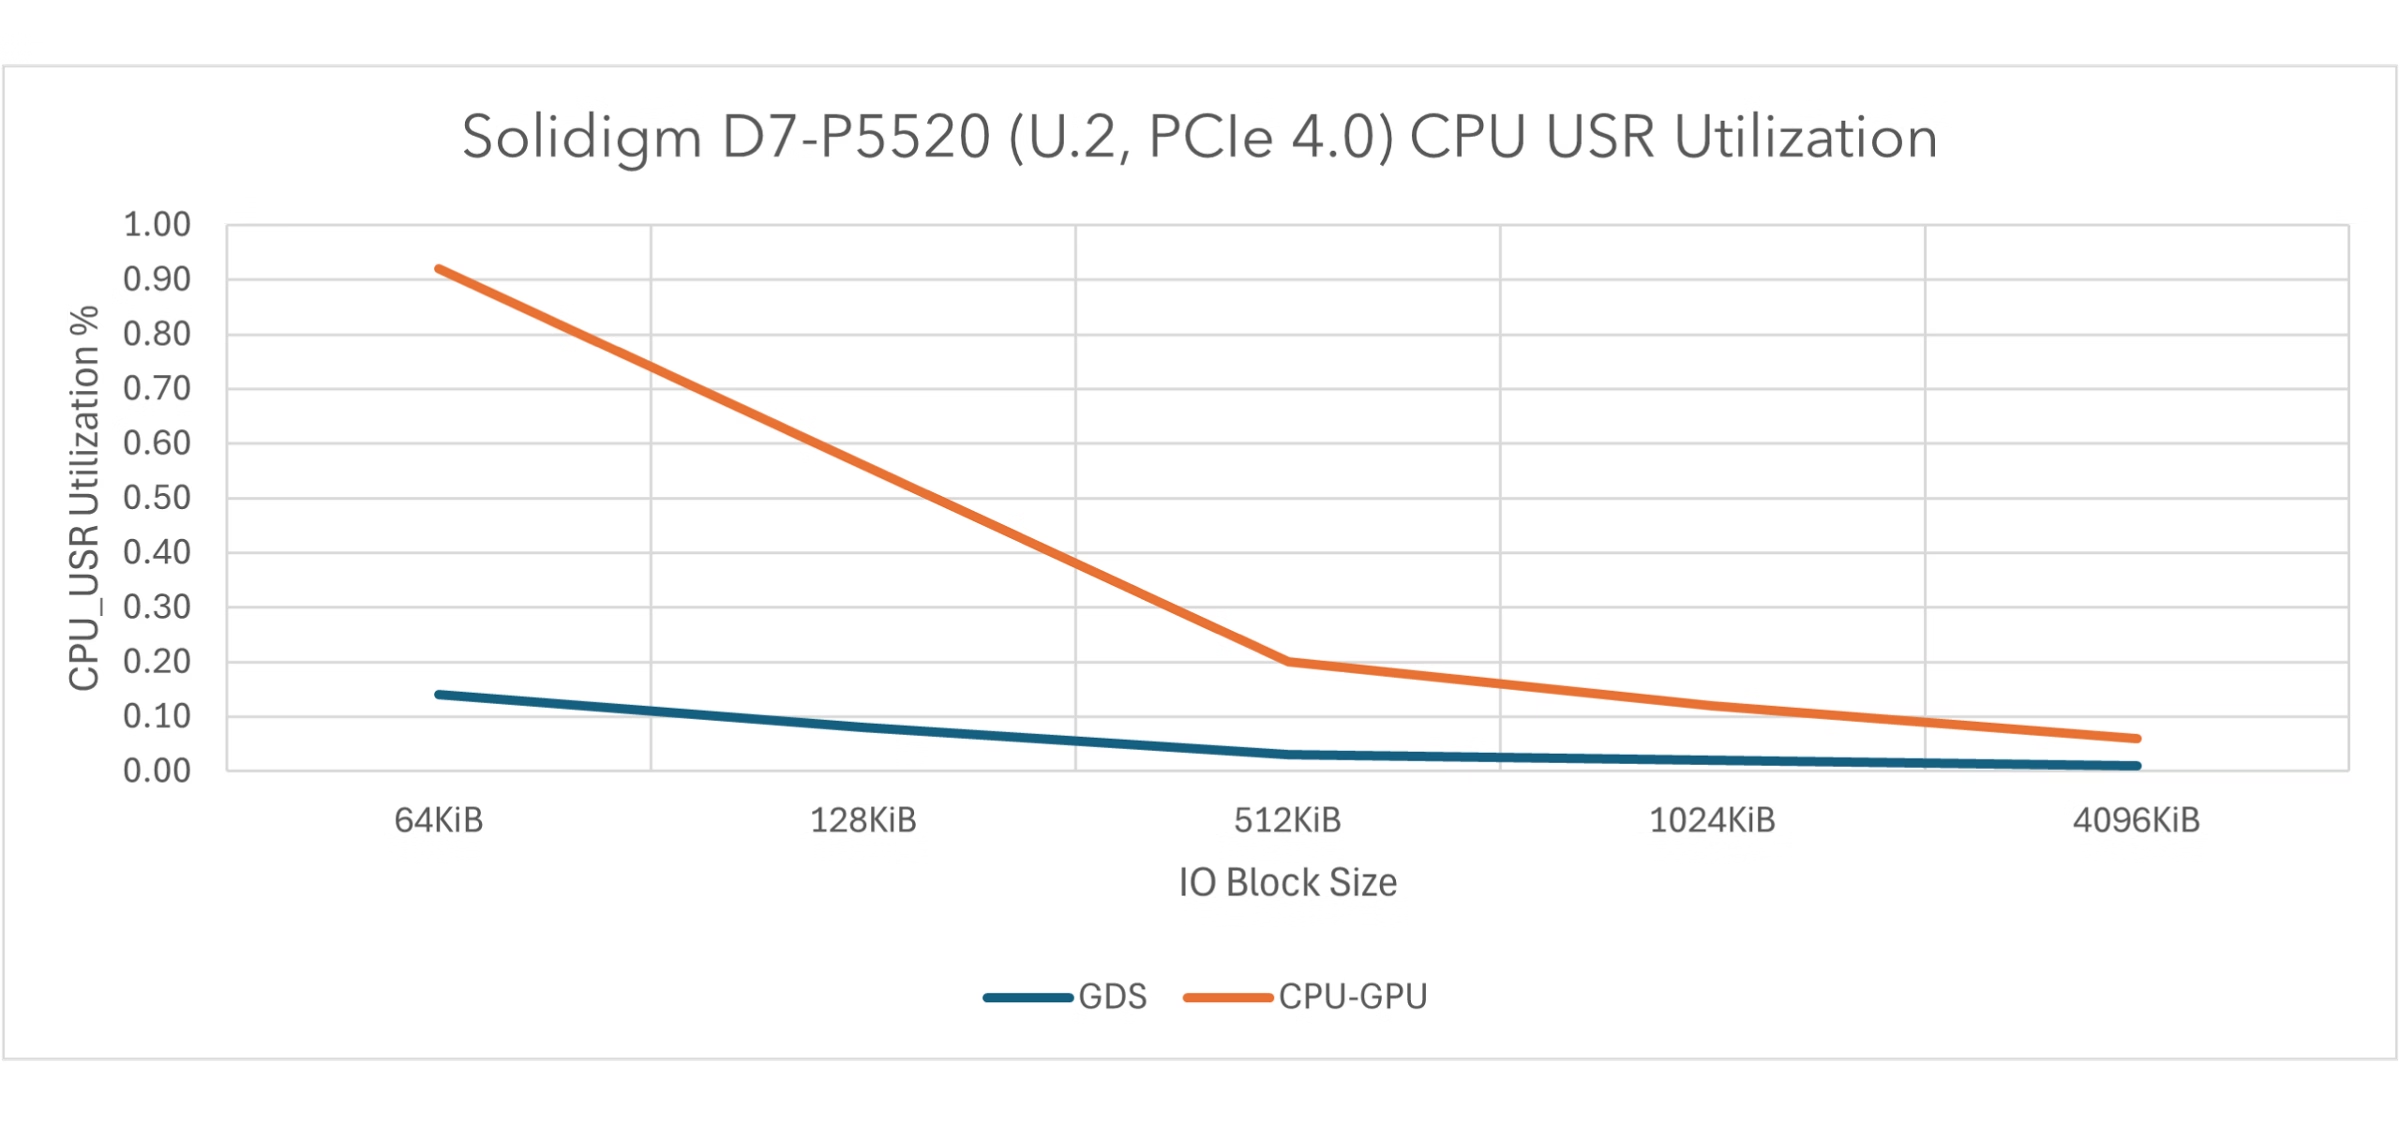
図5. Solidigm D7-PS1010のスループット
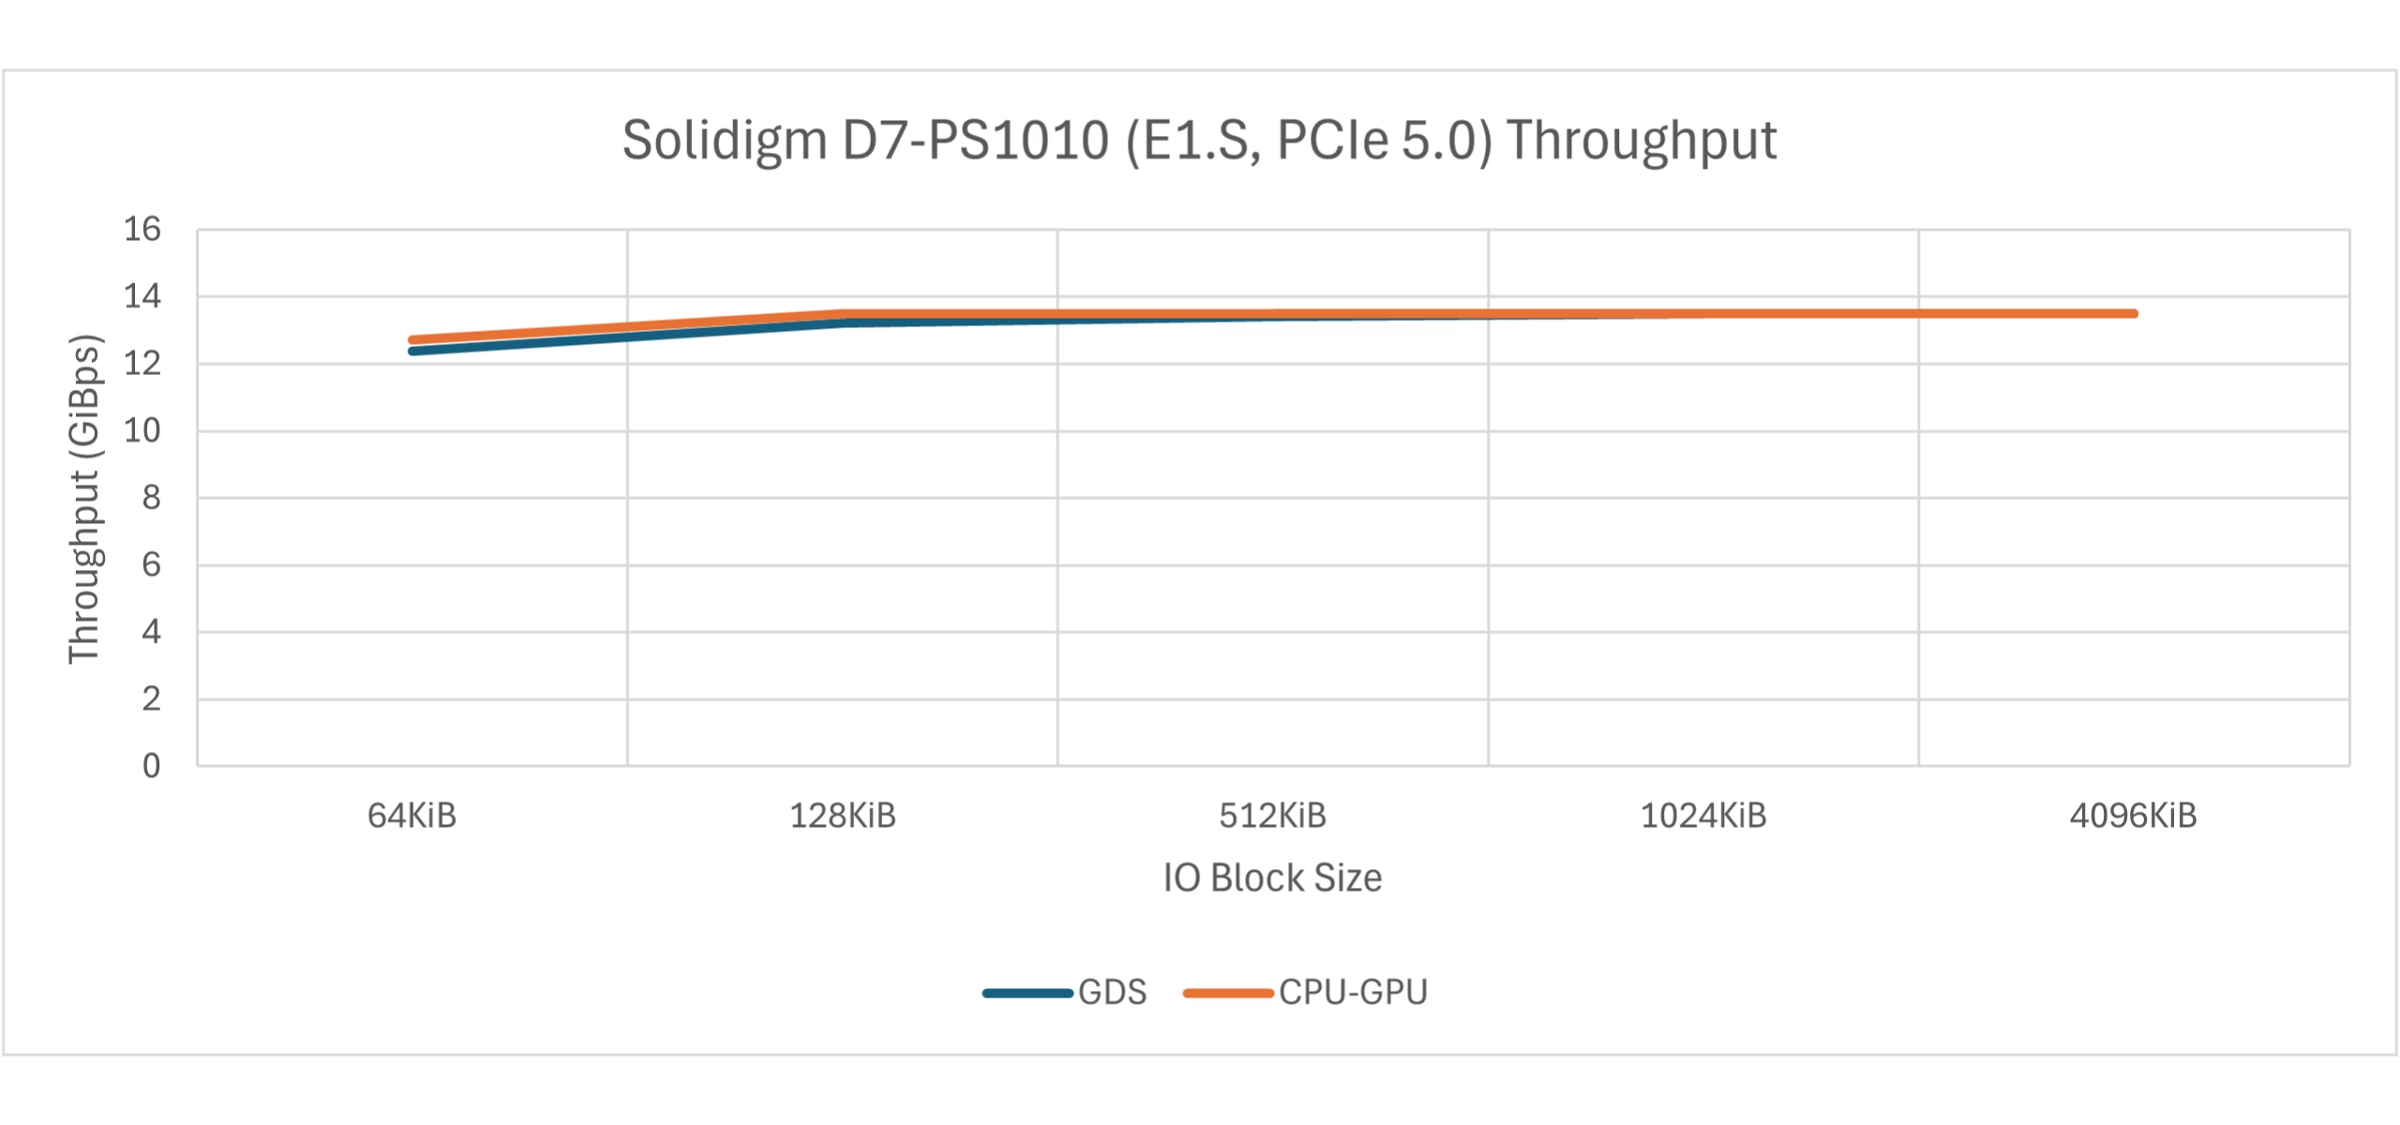
図6. Solidigm D7-PS1010の使用率
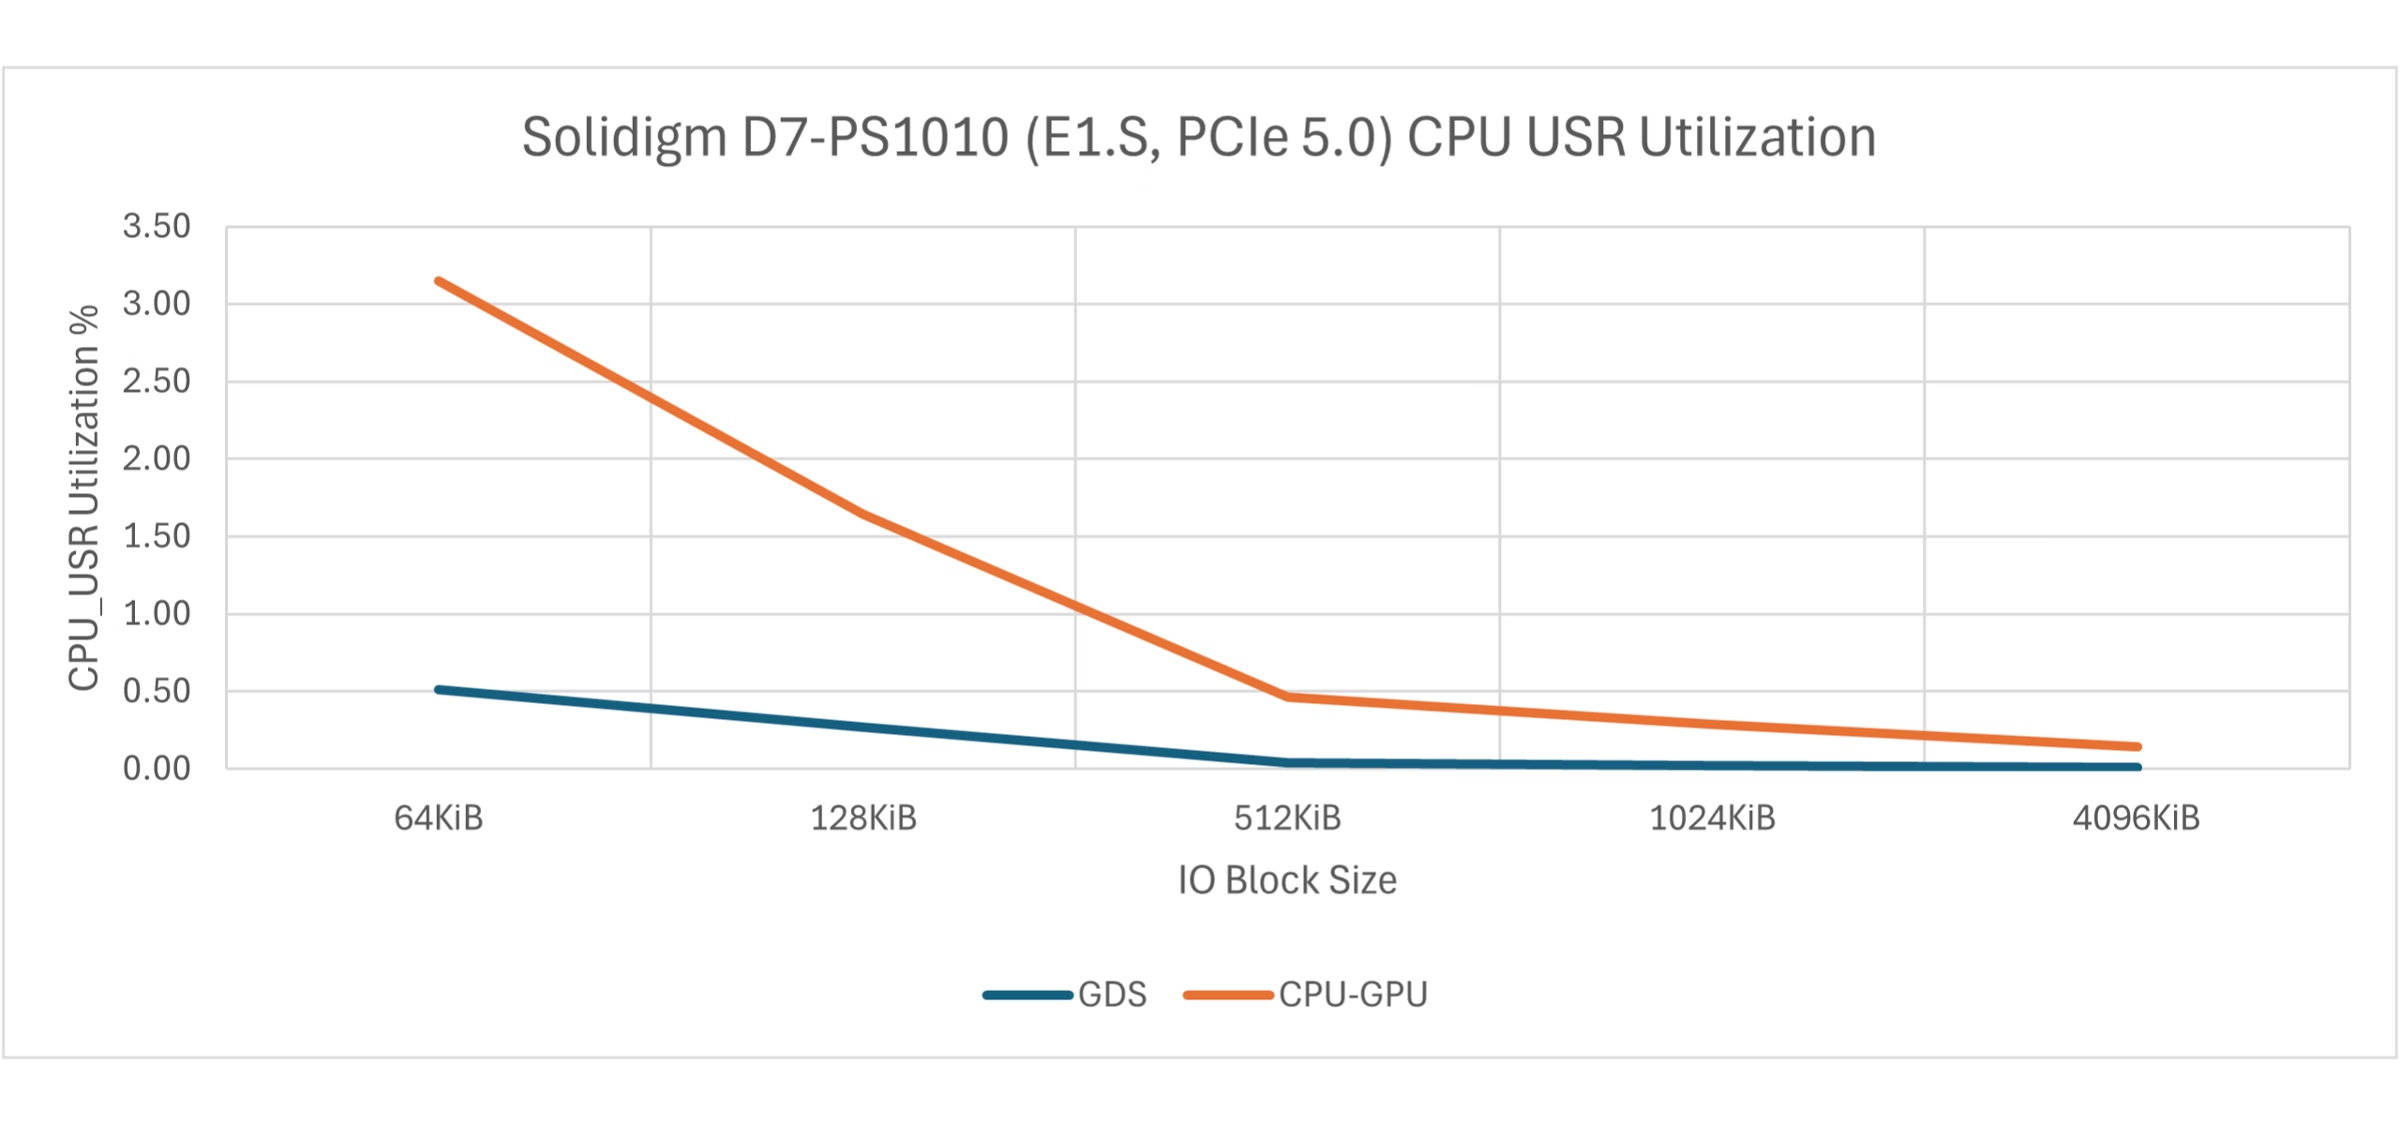
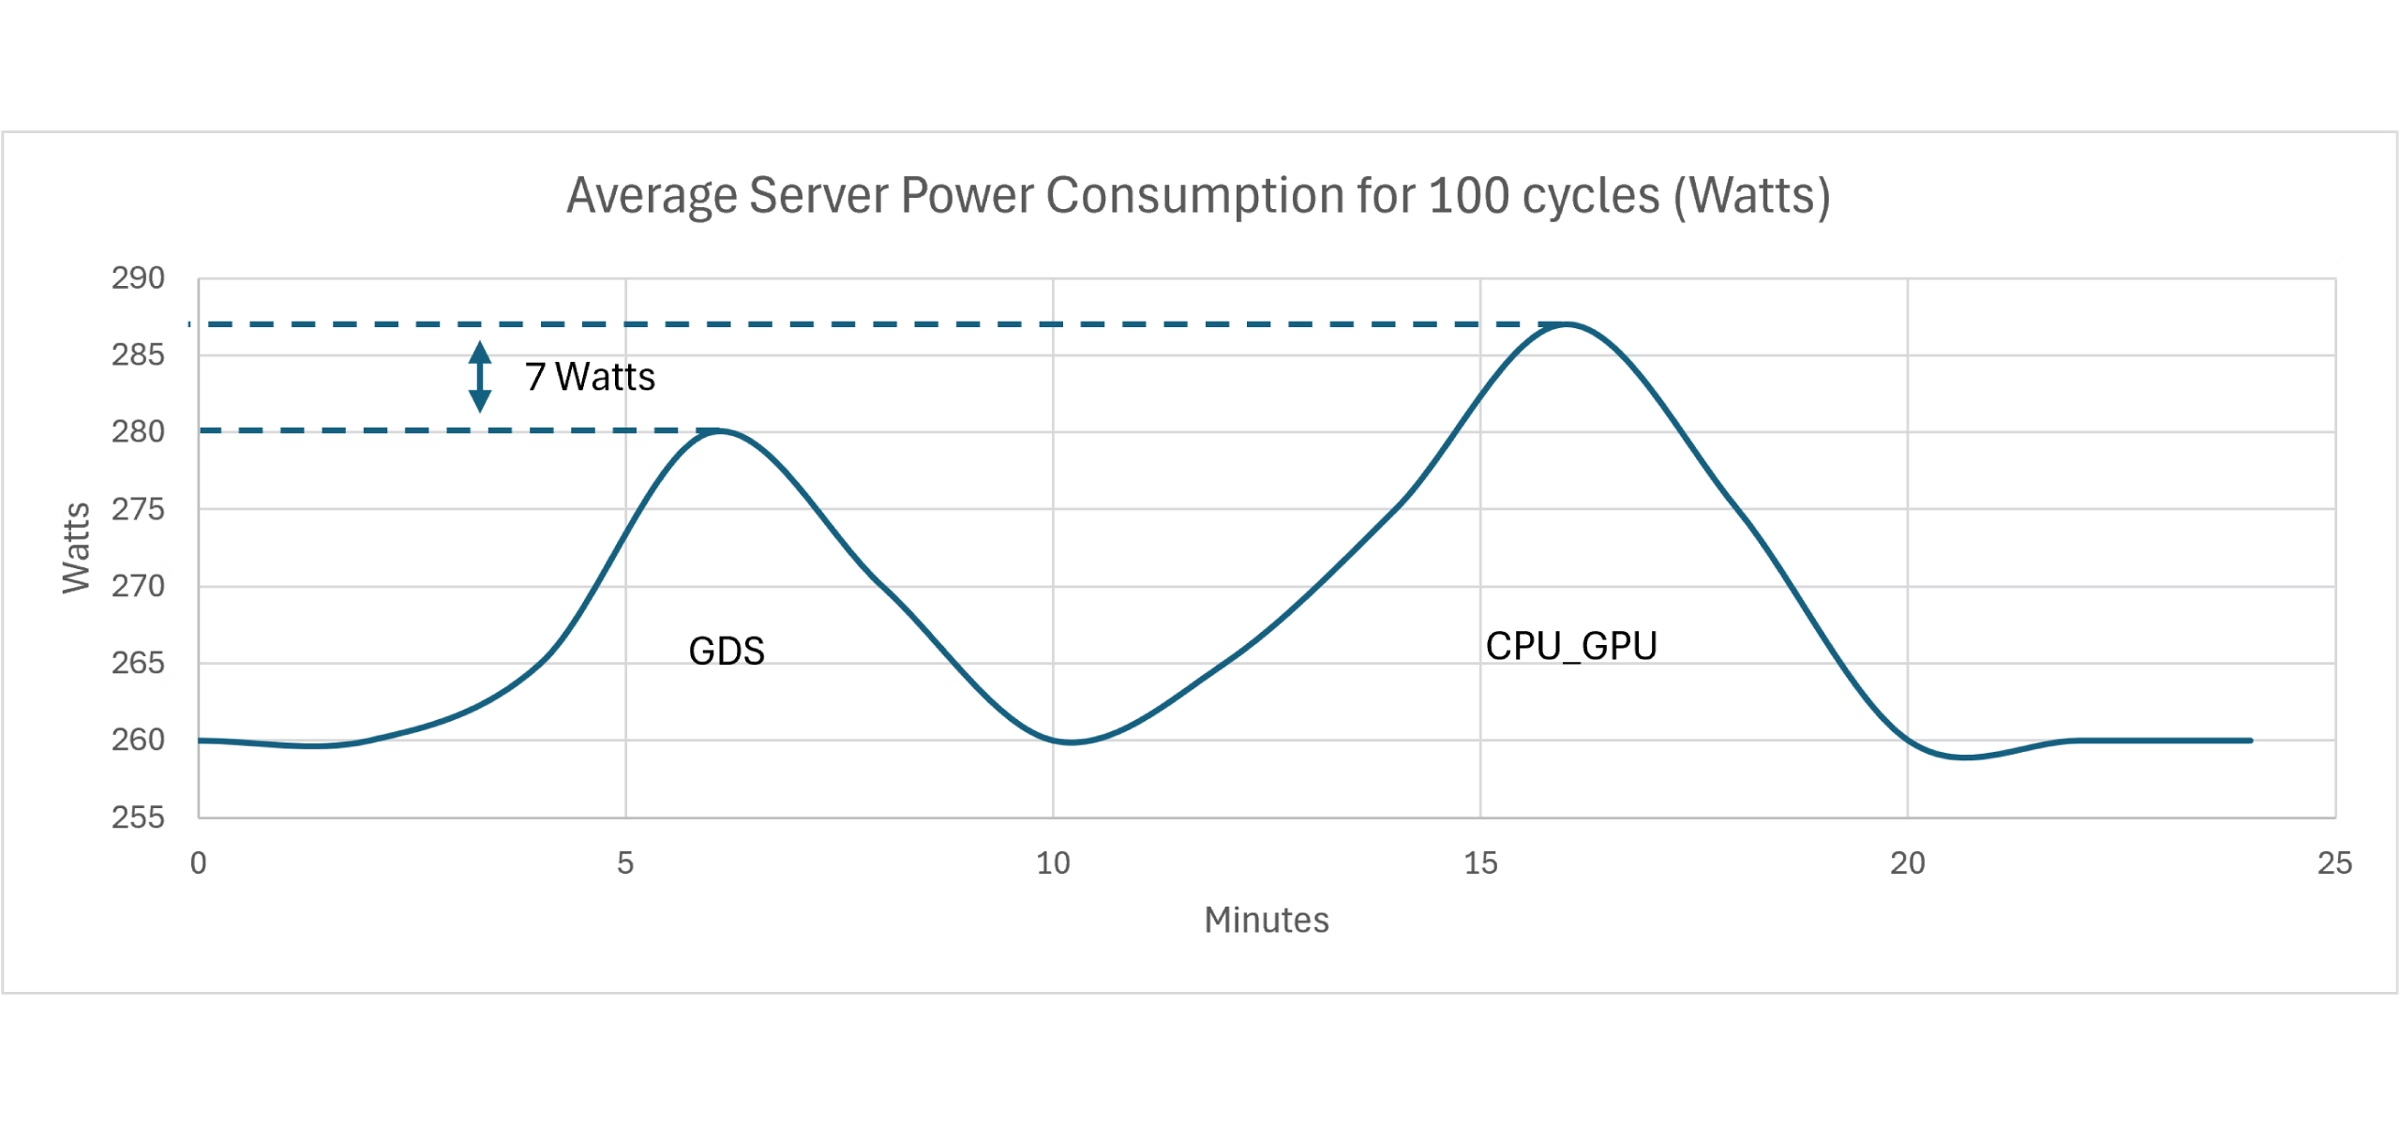
図7. 100サイクルの平均サーバー消費電力(ワット)
主なポイントと分析
- GDSは、すべてのブロックサイズにおいて、従来のCPU-GPUパスと同等のパフォーマンスとスループットを一貫して達成しています。
- GDSは、CPUを使用したRAMへの冗長なデータコピーを回避することでCPU使用率を低減し、アプリケーションタスクのためにコアを解放することがわかっています。
- GDSワークロードの実行時には、CPU-GPUワークロードと比較して、サーバー消費電力が約7ワット低くなります。このデータは複数回の実行(100サイクル)を通じて一貫しています。
NVIDIA Magnum IOアーキテクチャーによるリモートストレージのパフォーマンス
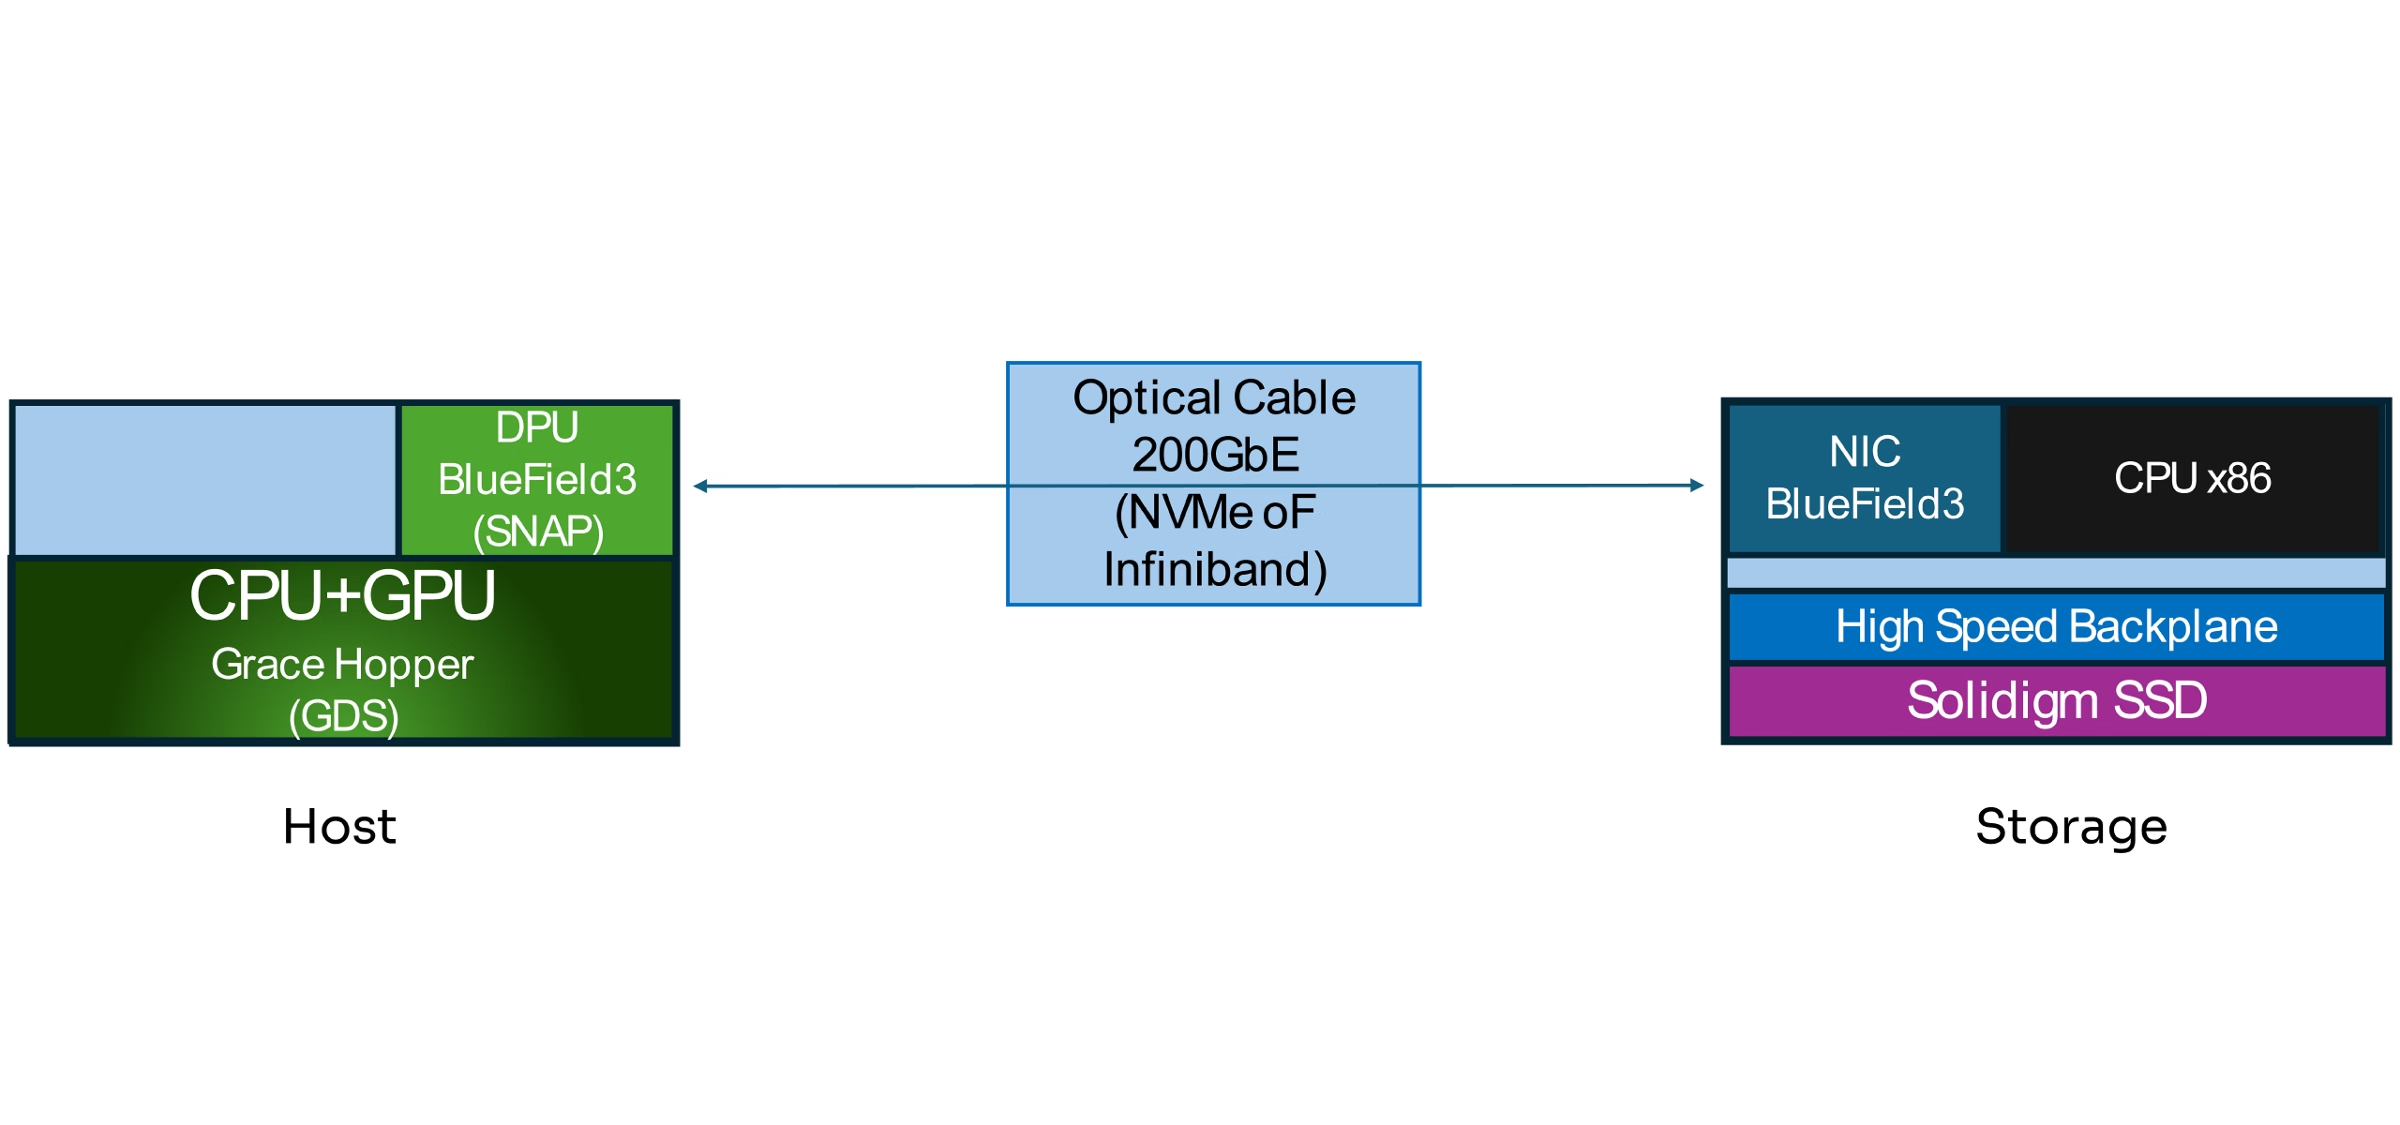
本項では、NVIDIA Magnum IO GPUDirect StorageとNVIDIA NVMe SNAPを含む NVIDIA Magnum IOアーキテクチャーにおけるSolidigm SSDの性能について述べます。1
NVIDIA DPU(データ処理ユニット)
DPUは、インフラタスク(ネットワーク、ストレージ、セキュリティ)をCPUからオフロードするために設計された専用プロセッサーです。NVIDIA Bluefield DPUは、マルチコアArm CPU、高速ネットワーク、ハードウェアアクセラレータを組み合わせて、データセンターの効率を最適化します。
SNAP(ソフトウェア定義NVMeアクセスプロトコル)
SNAPは、リモートSSDをローカルNVMeドライブとして仮想化するDPUアクセラレーションフレームワークです。NVIDIA DPU上のコンテナで動作するSNAPは、ローカルNVMeコマンドをNVMe-oFプロトコルパケットに変換し、リモートストレージとGPUメモリ間の直接RDMA転送を可能にします。
ファブリック上のNVMe(NVMe-oF)
NVMe-oFは、InfiniBandなどのネットワークを介してリモートストレージデバイスにアクセスするためにNVMeプロトコルを拡張したものです。これにより、共有ストレージプール、スケーラブルなリソース割り当てが可能になり、GPUやサーバーは、高性能SSDをローカルに接続しているかのように扱うことができます。
図8. Solidigm SSDを搭載したNVIDIA Magnum IOアーキテクチャー
エンドツーエンドのワークフロー
- ホストサーバーがGDS経由で連続読み出しを開始
GPUサーバーは、NVIDIA GPUDirect Storage(GDS)を活用するように設計された「gdsio」ベンチマークツールを使用して、連続読み出し操作をトリガーします。このツールはCPUとシステムメモリを完全にバイパスし、GPUのメモリ空間からDPUエミュレート1NVMeドライブに対してネイティブのNVMe読み出しコマンドを直接発行します。 - DPUがNVMeコマンドをインターセプトし、変換
DPUは、エミュレートされた1NVMeドライブのコントローラーとして機能し、NVMe読み出しコマンドをインターセプトします。DPUは、統合されたSNAPフレームワークを使用して、そのコマンドをNVMe-oFプロトコルパケットに変換します。この変換により、ローカルNVMe操作のセマンティクスを維持しつつ、ネットワーク経由のリモートストレージアクセスに適応します。 - ファブリックを介したRDMA転送
変換されたNVMe-oFコマンドは、GPUサーバーと物理Solidigm PCIe Gen5 SSDを収容するリモートストレージサーバーを接続する高速 InfiniBand RDMAファブリックを介して送信されます。データは、ホストメモリで中間的なステージングを行うことなく、リモート SSDからGPUのメモリバッファに直接流れ込みます。 - GPUメモリへの直接配置
DPUのSNAPフレームワークにより、取得されたデータはRDMA経由でGPUのメモリ空間に直接配置され、読み出し操作が完了します。このエンドツーエンドのパスにより、CPUの関与が排除され、ローカルに近いレイテンシーが維持され、スループットが最大化されます。 - SNAPキュー
ストレージ定義ネットワークアクセラレーション処理(SNAP)では、キューによりI/O操作の並列処理が可能となり、スループットが向上し、レイテンシーを低減します。1つのキューではなく32のキューを使用することで、複数のコアに負荷をより適切に分散でき、ボトルネックを防ぎ、パフォーマンスが向上します。この設定は、高トラフィックアプリケーションを効率的に処理し、より速い応答時間と拡張性を確保するために極めて重要です。
パフォーマンスベンチマーク:リモートストレージとローカルストレージの比較
リモート設定のシステム構成
ストレージサーバー
- サーバー:Supermicro AS1115C-TNR
- CPU: AMD EPYC 9124 (PCIe 5.0)
- DPU/NIC: B3140 Bluefield DPU 3
- SSD:
Solidigm D7-PS1010 (E1.S, 7.68TB, PCIe 5.0)
Solidigm D7-P5520 (U.2, 7.68TB, PCIe 4.0) - OS: Ubuntu 20.04.6 LTS
- カーネル:5.4.0-205-generic
コンピューティングサーバー
- サーバー:Supermicro ARS-111GL-NHR
- CPU/GPU: Grace Hopper 200
- DPU: B3240 Bluefield DPU 3
- OS: Ubuntu 22.04.5 LTS
- カーネル:6.8.0-1021-nvidia-64k
- Cuda: 12.6
- GDSIO: 1.11
方法
2つのデータパスを比較します
- ローカルストレージ:GDS経由でアクセスする直接接続型SSD。
- リモートストレージ:GDS経由で接続したDPUエミュレート1NVMe-oFドライブ(InfiniBand経由のSSD)。
ベンチマークパラメータ
- ブロックサイズ:64KiB、128KiB、512KiB、1024KiB、4096KiB
- SNAPキュー:1、7、15、23、31
- ワークロード:連続読み出し
- キュー深度(QD):24/32
- 指標:スループット(GB/s)
- ランタイム:45秒
結果
| IOサイズ | PCIe 4.0 – Solidigm D7-D5520 7.68TB FW: 9CV10330 | PCIe 5.0 – Solidigm D7-PS1010 7.68TB FW:G77YG100 | ||
|---|---|---|---|---|
| 直接設定(GiBps) | リモート設定(GiBps) | 直接設定(GiBps) | リモート設定(GiBps) | |
| 64KiB | 4.42 | 4.14 | 12.38 | 10.42 |
| 128KiB | 5.27 | 5.07 | 13.20 | 13.16 |
| 512KiB | 6.50 | 6.45 | 13.41 | 13.50 |
| 1024KiB | 6.58 | 6.70 | 13.48 | 13.85 |
| 4096KiB | 6.46 | 6.50 | 13.48 | 13.85 |
表3. PCIe 4.0とPCIe 5.0の比較結果
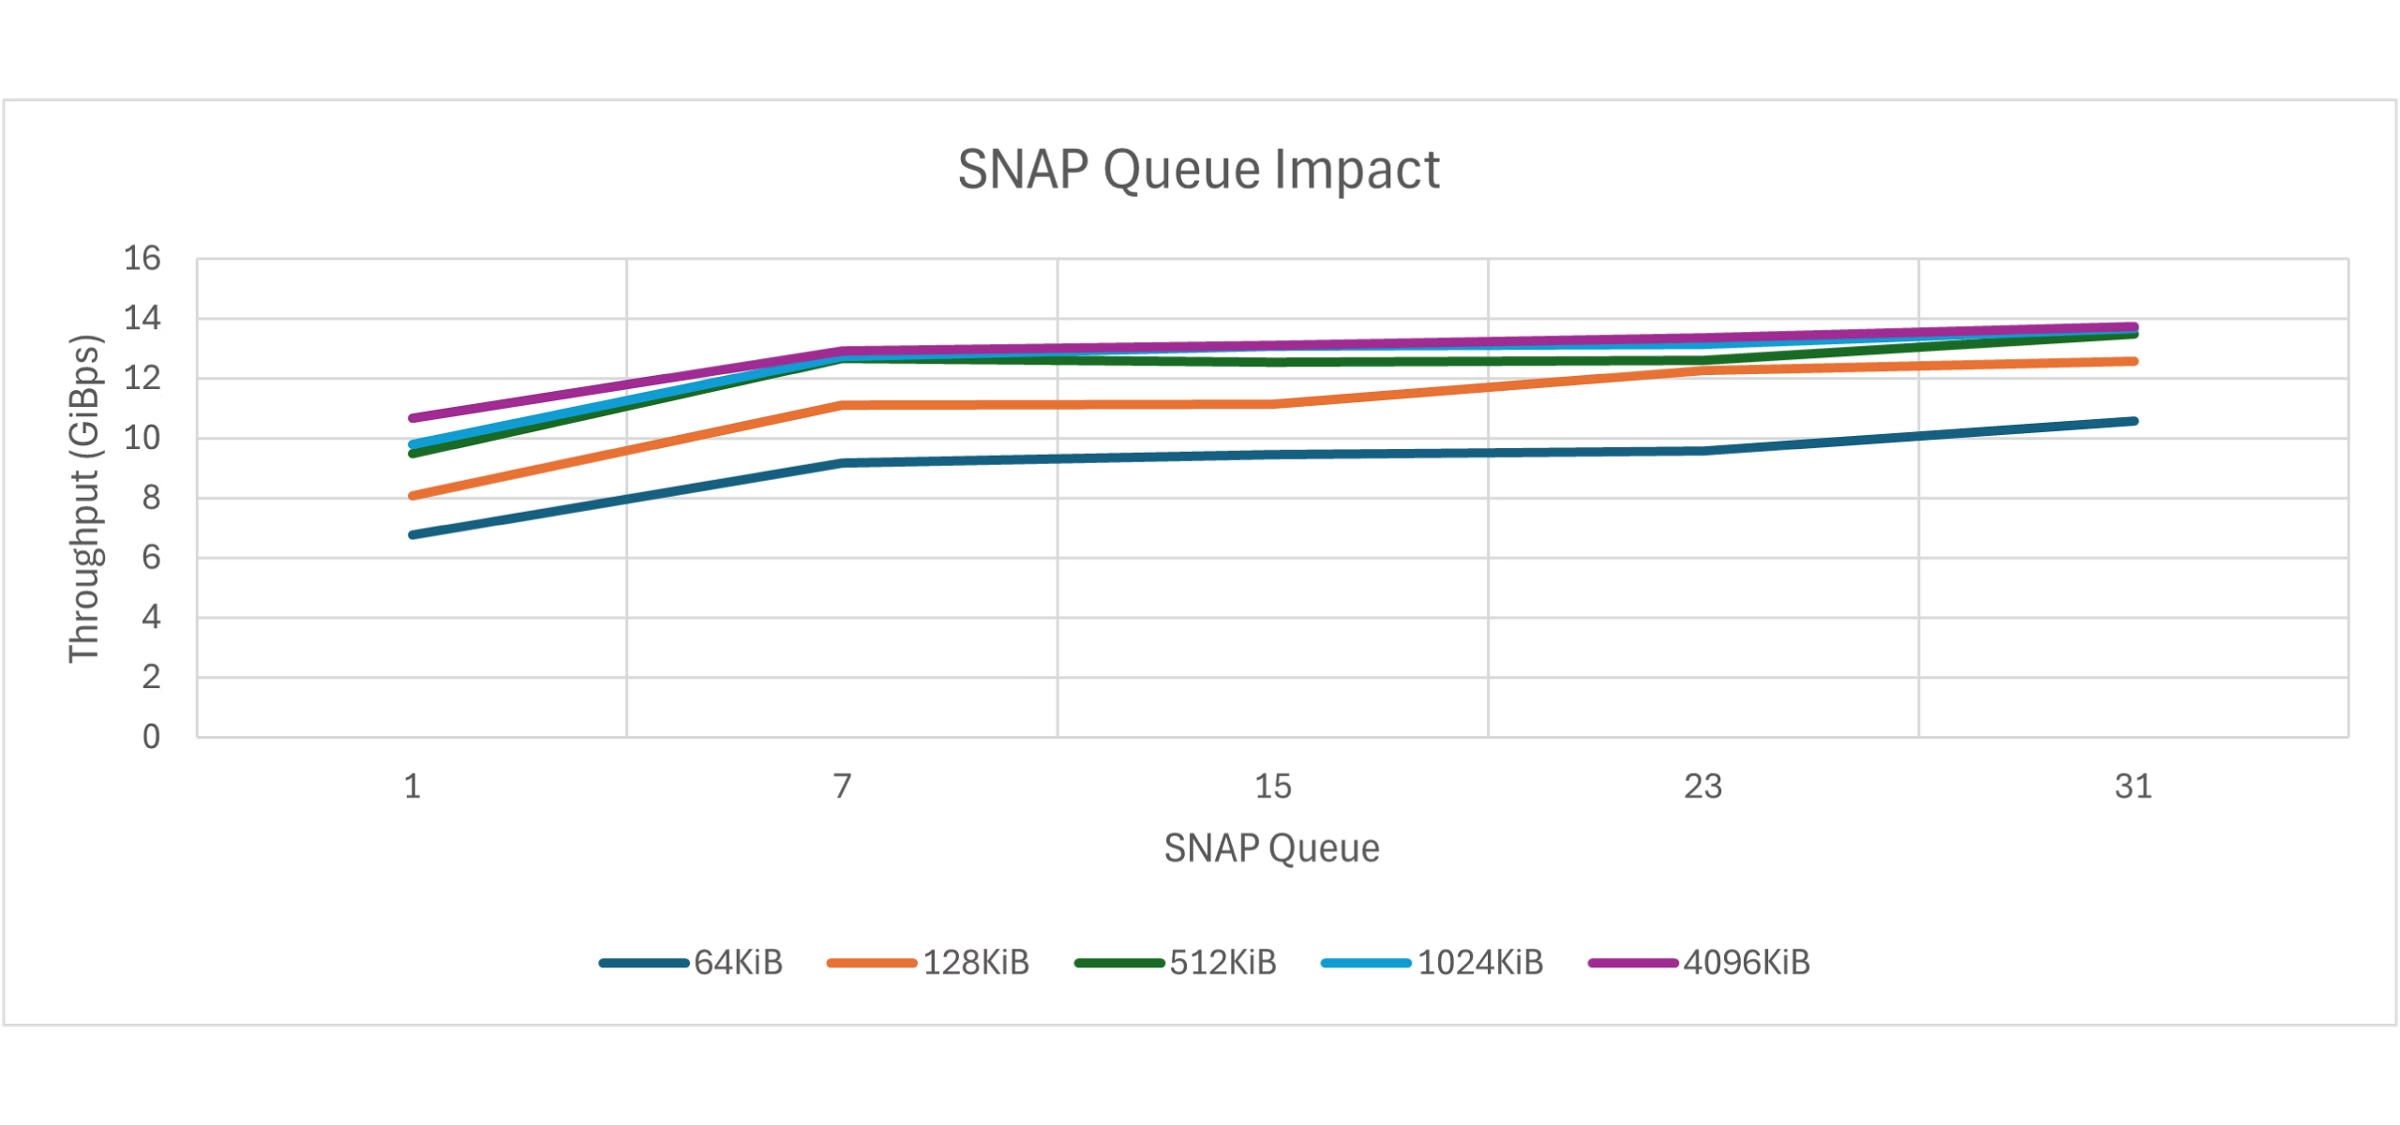
SNAPキューがSolidigm D7-PS1010 E1.S 7.68TBに与える影響
| SNAPキュー: | 1 (GiBps) | 7 (GiBps) | 15 (GiBps) | 23 (GiBps) | 31(GiBps) |
|---|---|---|---|---|---|
| 64KiB | 6.77 | 8.06 | 9.48 | 9.78 | 10.68 |
| 128KiB | 9.18 | 11.1 | 12.68 | 12.73 | 12.93 |
| 512KiB | 9.44 | 11.15 | 12.53 | 13.06 | 13.09 |
| 1024KiB | 9.56 | 12.25 | 12.59 | 13.15 | 13.34 |
| 4096KiB | 10.57 | 12.56 | 13.48 | 13.67 | 13.73 |
表4. SNAPキューの影響
図9. Solidigm D7-P5520のスループット
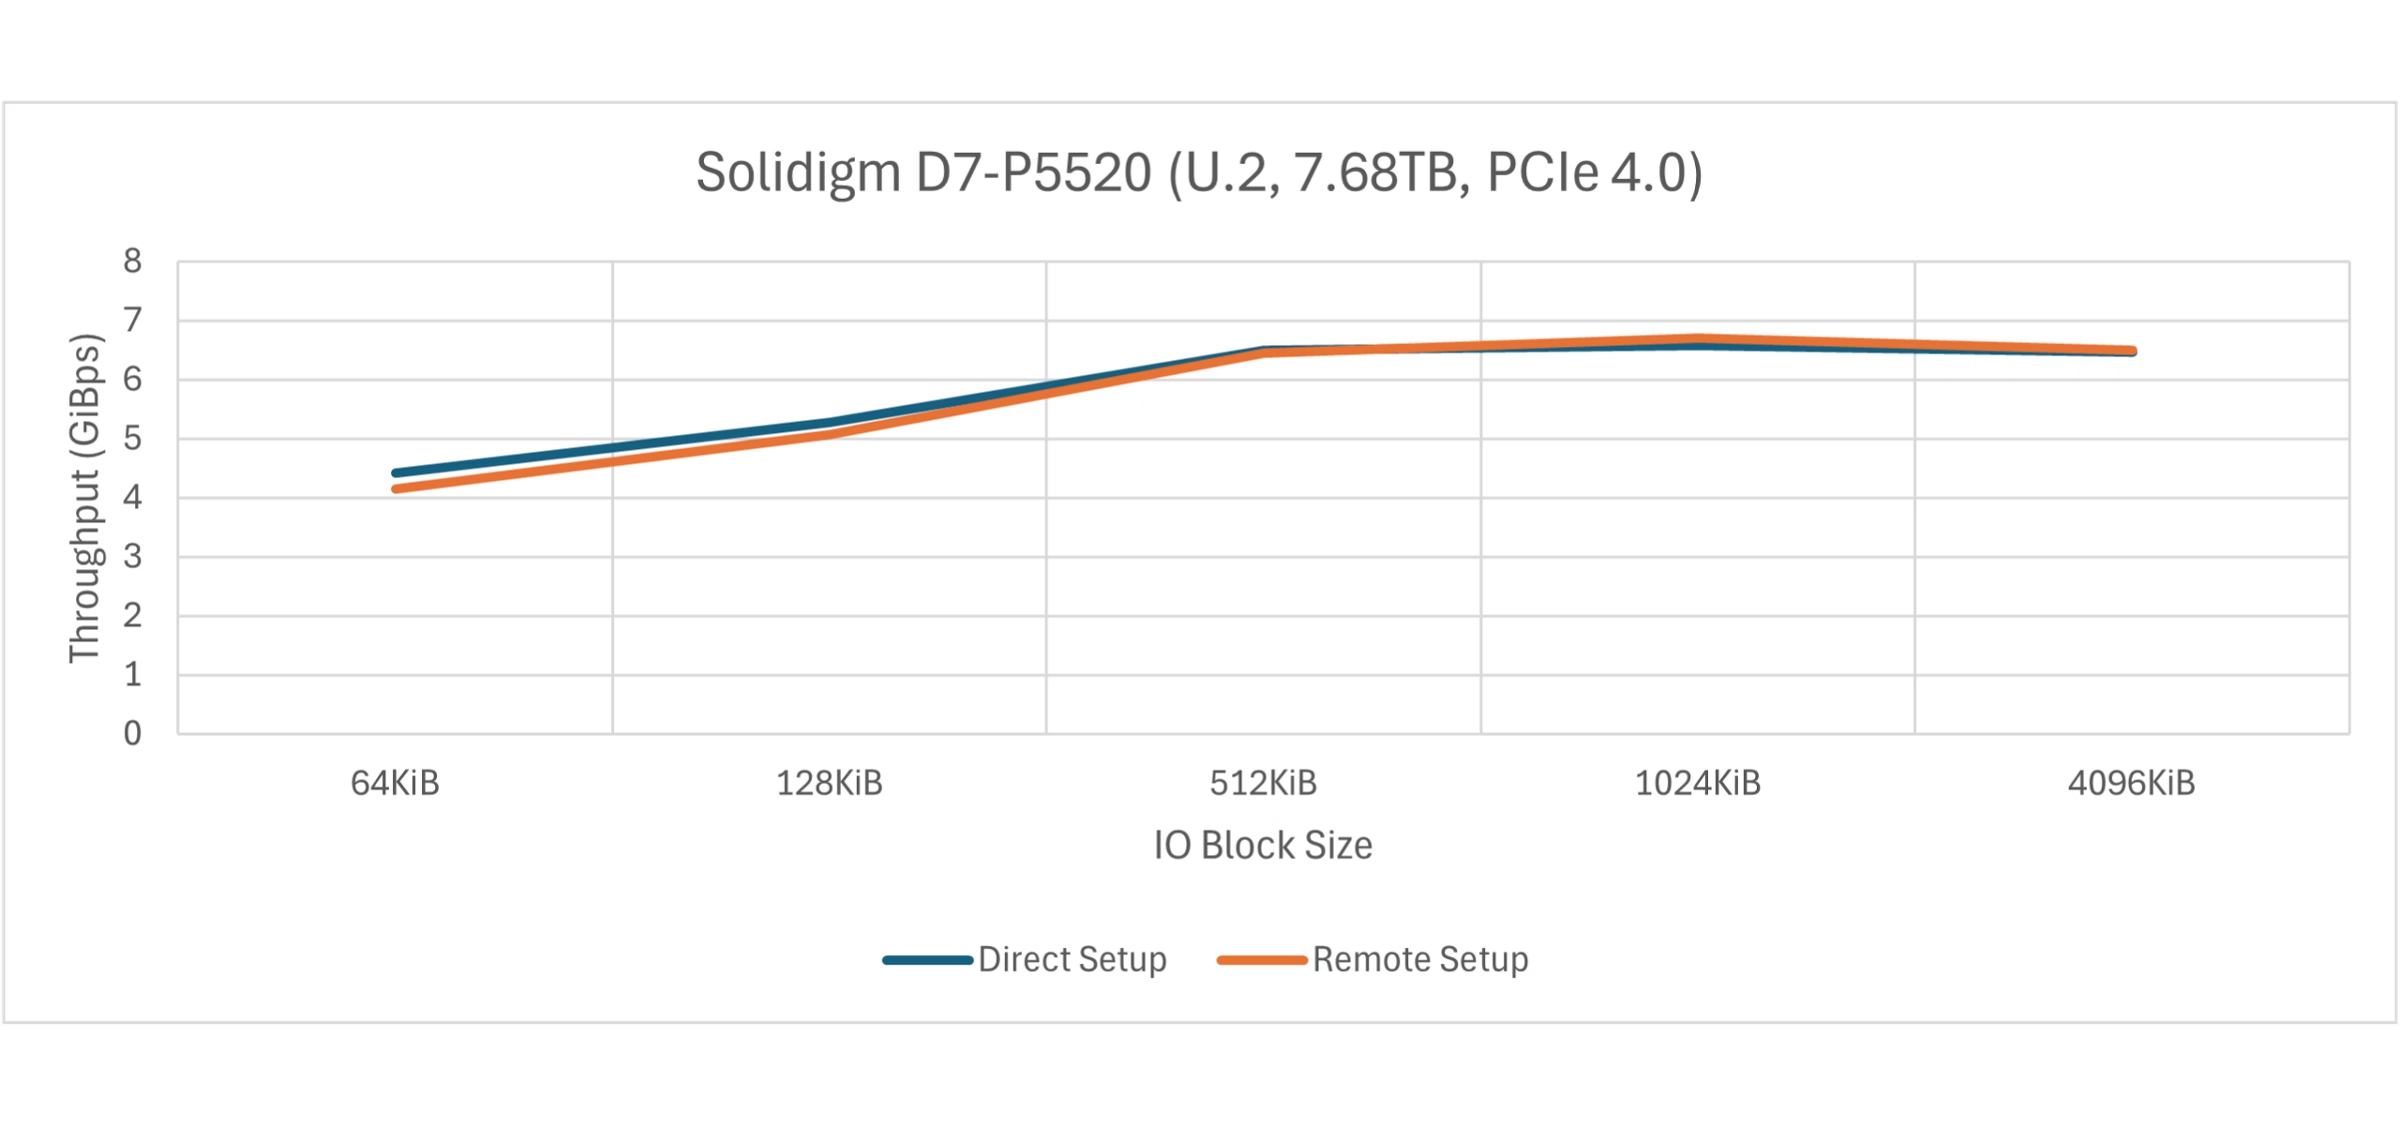
図10. Solidigm D7-PS1010のスループット
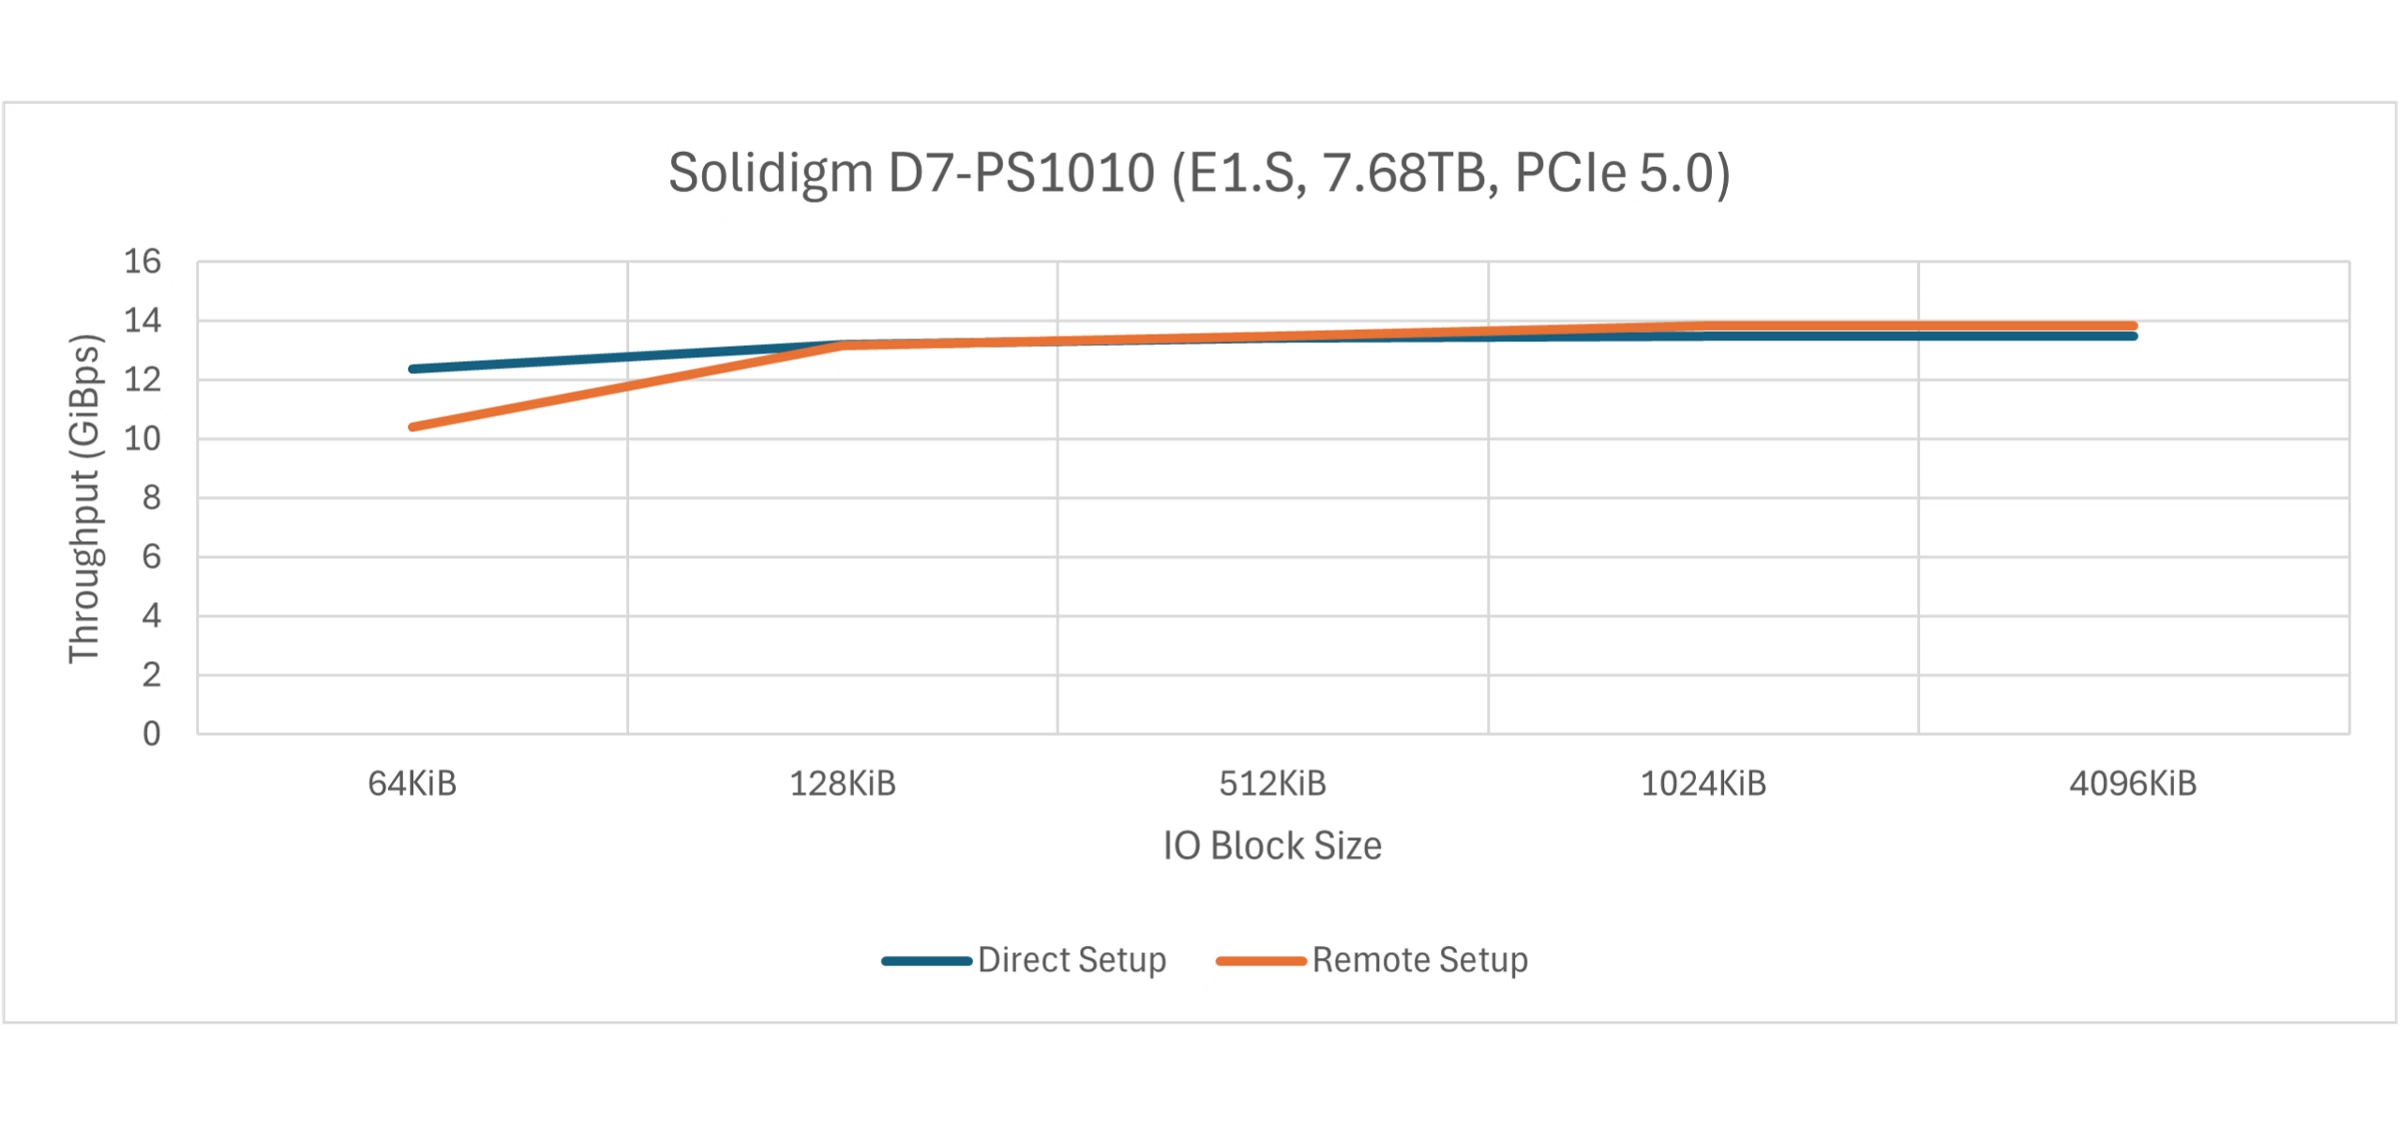
図11. SNAPキューの影響
主なポイントと分析
1. スループットのパリティ
NVIDIA Bluefield DPUのプロトコルオフロードとRDMAはファブリックのオーバーヘッドを最小限に抑え、ローカルに近いスループットを実現します。PCIe Gen4とPCIe Gen5のグラフを見るとわかるように、リモートストレージ設定のスループットはローカルストレージ設定のスループットと同等です。
2. ブロックサイズの影響
また、ブロックサイズが大きくなるにつれて、リモートストレージ設定のスループットはローカルストレージ設定と比較してわずかに増加する一方で、ブロックサイズが小さい場合は、ファブリック上のオーバーヘッドが高くなるため、リモートストレージ設定のスループットはわずかに低くなることも確認できます。
3. SNAPキューの影響
リモートストレージ設定を有効化する際は、SNAPキューも考慮すべき重要な要素です。SNAPキューの数を32に増やすことで、同時処理されるI/Oリクエストが増加し、潜在的なボトルネックが軽減されるため、さまざまなキューサイズに関するグラフに示されている通り、スループットが向上します。
まとめと今後の方向性
本ホワイトペーパーでは、NVIDIA GPUDirect StorageをSolidigm PCIe Gen5 SSDとDPU駆動のNVMe-oFエミュレーション1と組み合わせることで、リモートストレージがローカルNVMeドライブと同等のパフォーマンスを実現できることについて述べています。CPUのボトルネックを解消し、高速InfiniBandファブリック上のRDMAを活用することで、このアーキテクチャーは、AIの加速を損なうことなく、スケーラブルでコスト効率の高いAIインフラを実現します。これは、中央集約型ストレージプールがGPUワークロードの効率を維持しつつ、ローカルドライブに取って代わることができることを示しています。
AIインフラへの影響
組織は、ストレージをコンピューティングノードから分離することで、ハードウェアの乱立と運用コストを削減できます。また、DPUオフロードと合理化されたデータパスによる省エネ効果により、持続可能な拡張が実現します。このアプローチは、共有データセットへの低レイテンシーアクセスが重要な分散トレーニングワークフローやエッジ推論の展開において、特に大きな効果を発揮します。
今後、800Gネットワーク、DPUアクセラレーションによる計算ストレージ、KubernetesやMLフレームワークとの深い統合が進むことで、このアーキテクチャーは次世代AIデータセンターの基盤としてさらに確固たるものとなるでしょう。
推奨事項
組織は、大量データワークロード向けにSolidigm PCIe Gen4および/またはGen5 SSDを採用し、レイテンシーを最小限に抑えるためにRDMA対応ファブリックを導入することで、GDSとDPUの採用を検討し、AIインフラの将来性を確保できます。この統合アーキテクチャーにより、企業はパフォーマンスとコスト効率を維持しながらGPUリソースを拡張することが可能となります。
Ashwin Pai(アシュウィン・パイ)は、Solidigmのシステム検証エンジニアで、ソフトウェア、ハードウェア、システムエンジニアリング分野で10年近くの経験を有しています。注力しているのは、AIとデータ集約型ワークロード向けに最適化されたものを含む、多様なプラットフォームにおける次世代SSD技術の検証です。Ashwinは、高度なAI手法と画期的なイノベーションを活用してAI駆動環境におけるSolidigm SSDの機能を強化するため、部門横断的なチームと協力しています。VES工科大学で電子工学の学士号を、ノースカロライナ州立大学でコンピュータ工学の修士号を取得しています。
Akhil Srinivas(アキール・シュリニヴァース)は、Solidigmの電気・システムエンジニアです。業界をリードするエコシステムベンダーと連携し、最先端のストレージソリューション向けにSolidigm SSDの検証を行っています。新たに登場するAI技術と先駆的なイノベーションを活用し、Solidigm SSDを次世代プラットフォームの重要なコンポーネントとして位置付け、AI分野におけるパートナーシップの強化に取り組んでいます。仕事以外では料理の探求に没頭し、全米で人気のフードトラックやレストランを訪れています。Akhilは、インドのRV工科大学で電気通信工学の学士号を、カリフォルニア大学デービス校で電気工学とコンピュータ工学の修士号を取得しています。
1. GDSとDOCAの設定とインストールについては、以下のリンクを参照しています。
2. 実行されたワークロード
- gdsio -T 45 -s 512M -I 0 -x 0 -D /mnt -w 32 -d 0 -i 64k
- gdsio -T 45 -s 512M -I 0 -x 0 -D /mnt -w 32 -d 0 -i 128k
- gdsio -T 45 -s 2048M -I 0 -x 0 -D /mnt -w 24 -d 0 -i 512k
- gdsio -T 45 -s 2048M -I 0 -x 0 -D /mnt -w 24 -d 0 -i 1024k
- gdsio -T 45 -s 2048M -I 0 -x 0 -D /mnt -w 24 -d 0 -i 4096k
<T>はテストの継続時間を秒単位で指定します
<s>はデータセットのサイズを設定します
<I>は反復回数を示し、0は通常、テスト期間の終了までの継続的または無制限の反復を意味します
<x>は転送タイプを定義し、0は通常、読み出し操作を表します
<D>はテストファイルが保存されるディレクトリパスを設定します
<w>はテスト中に使用するワーカースレッド数を指定します
<d>は使用するGPUデバイスIDを示します。<i>はI/Oサイズを設定します
3. サーバー管理コンソールを使用してサーバー消費電力を計測しました。
1. NVIDIA DOCA SNAPにおいて、エミュレーションとは、ホストシステムに対して実際のハードウェアと同様の動作をするソフトウェアベースのNVMeデバイスの作成を指します。
©2025, Solidigm. 「Solidigm」は、米国、中華人民共和国、シンガポール、日本、欧州連合、英国、メキシコ、その他の国における、SK hynix NAND Product Solutions Corp(商号:Solidigm)の登録商標です。
その他の社名、製品名などは、一般に各社の表示、商標または登録商標です。
Solidigm製品は、予告なく仕様や説明が変更されることがあります。
テストでは、特定のシステムでの個々のテストにおけるコンポーネントのパフォーマンスを文書化しています。
ハードウェア、ソフトウェア、システム構成などの違いにより、実際のパフォーマンスは掲載されたパフォーマンステストや評価とは異なる場合があります。
購入を検討される場合は、ほかの情報も参考にして、パフォーマンスを総合的に評価することをお勧めします。
文書化された結果は暫定的なものであり、情報提供のみを目的としています。これらの数値や記述は最終的なものでも公式なものでもありません。
ドライブはエンジニアリングサンプルとみなされます。本番環境に関するガイダンスについては、ロードマップを参照してください。